

PyTorch 现在能原生跑在 TPU 上了。
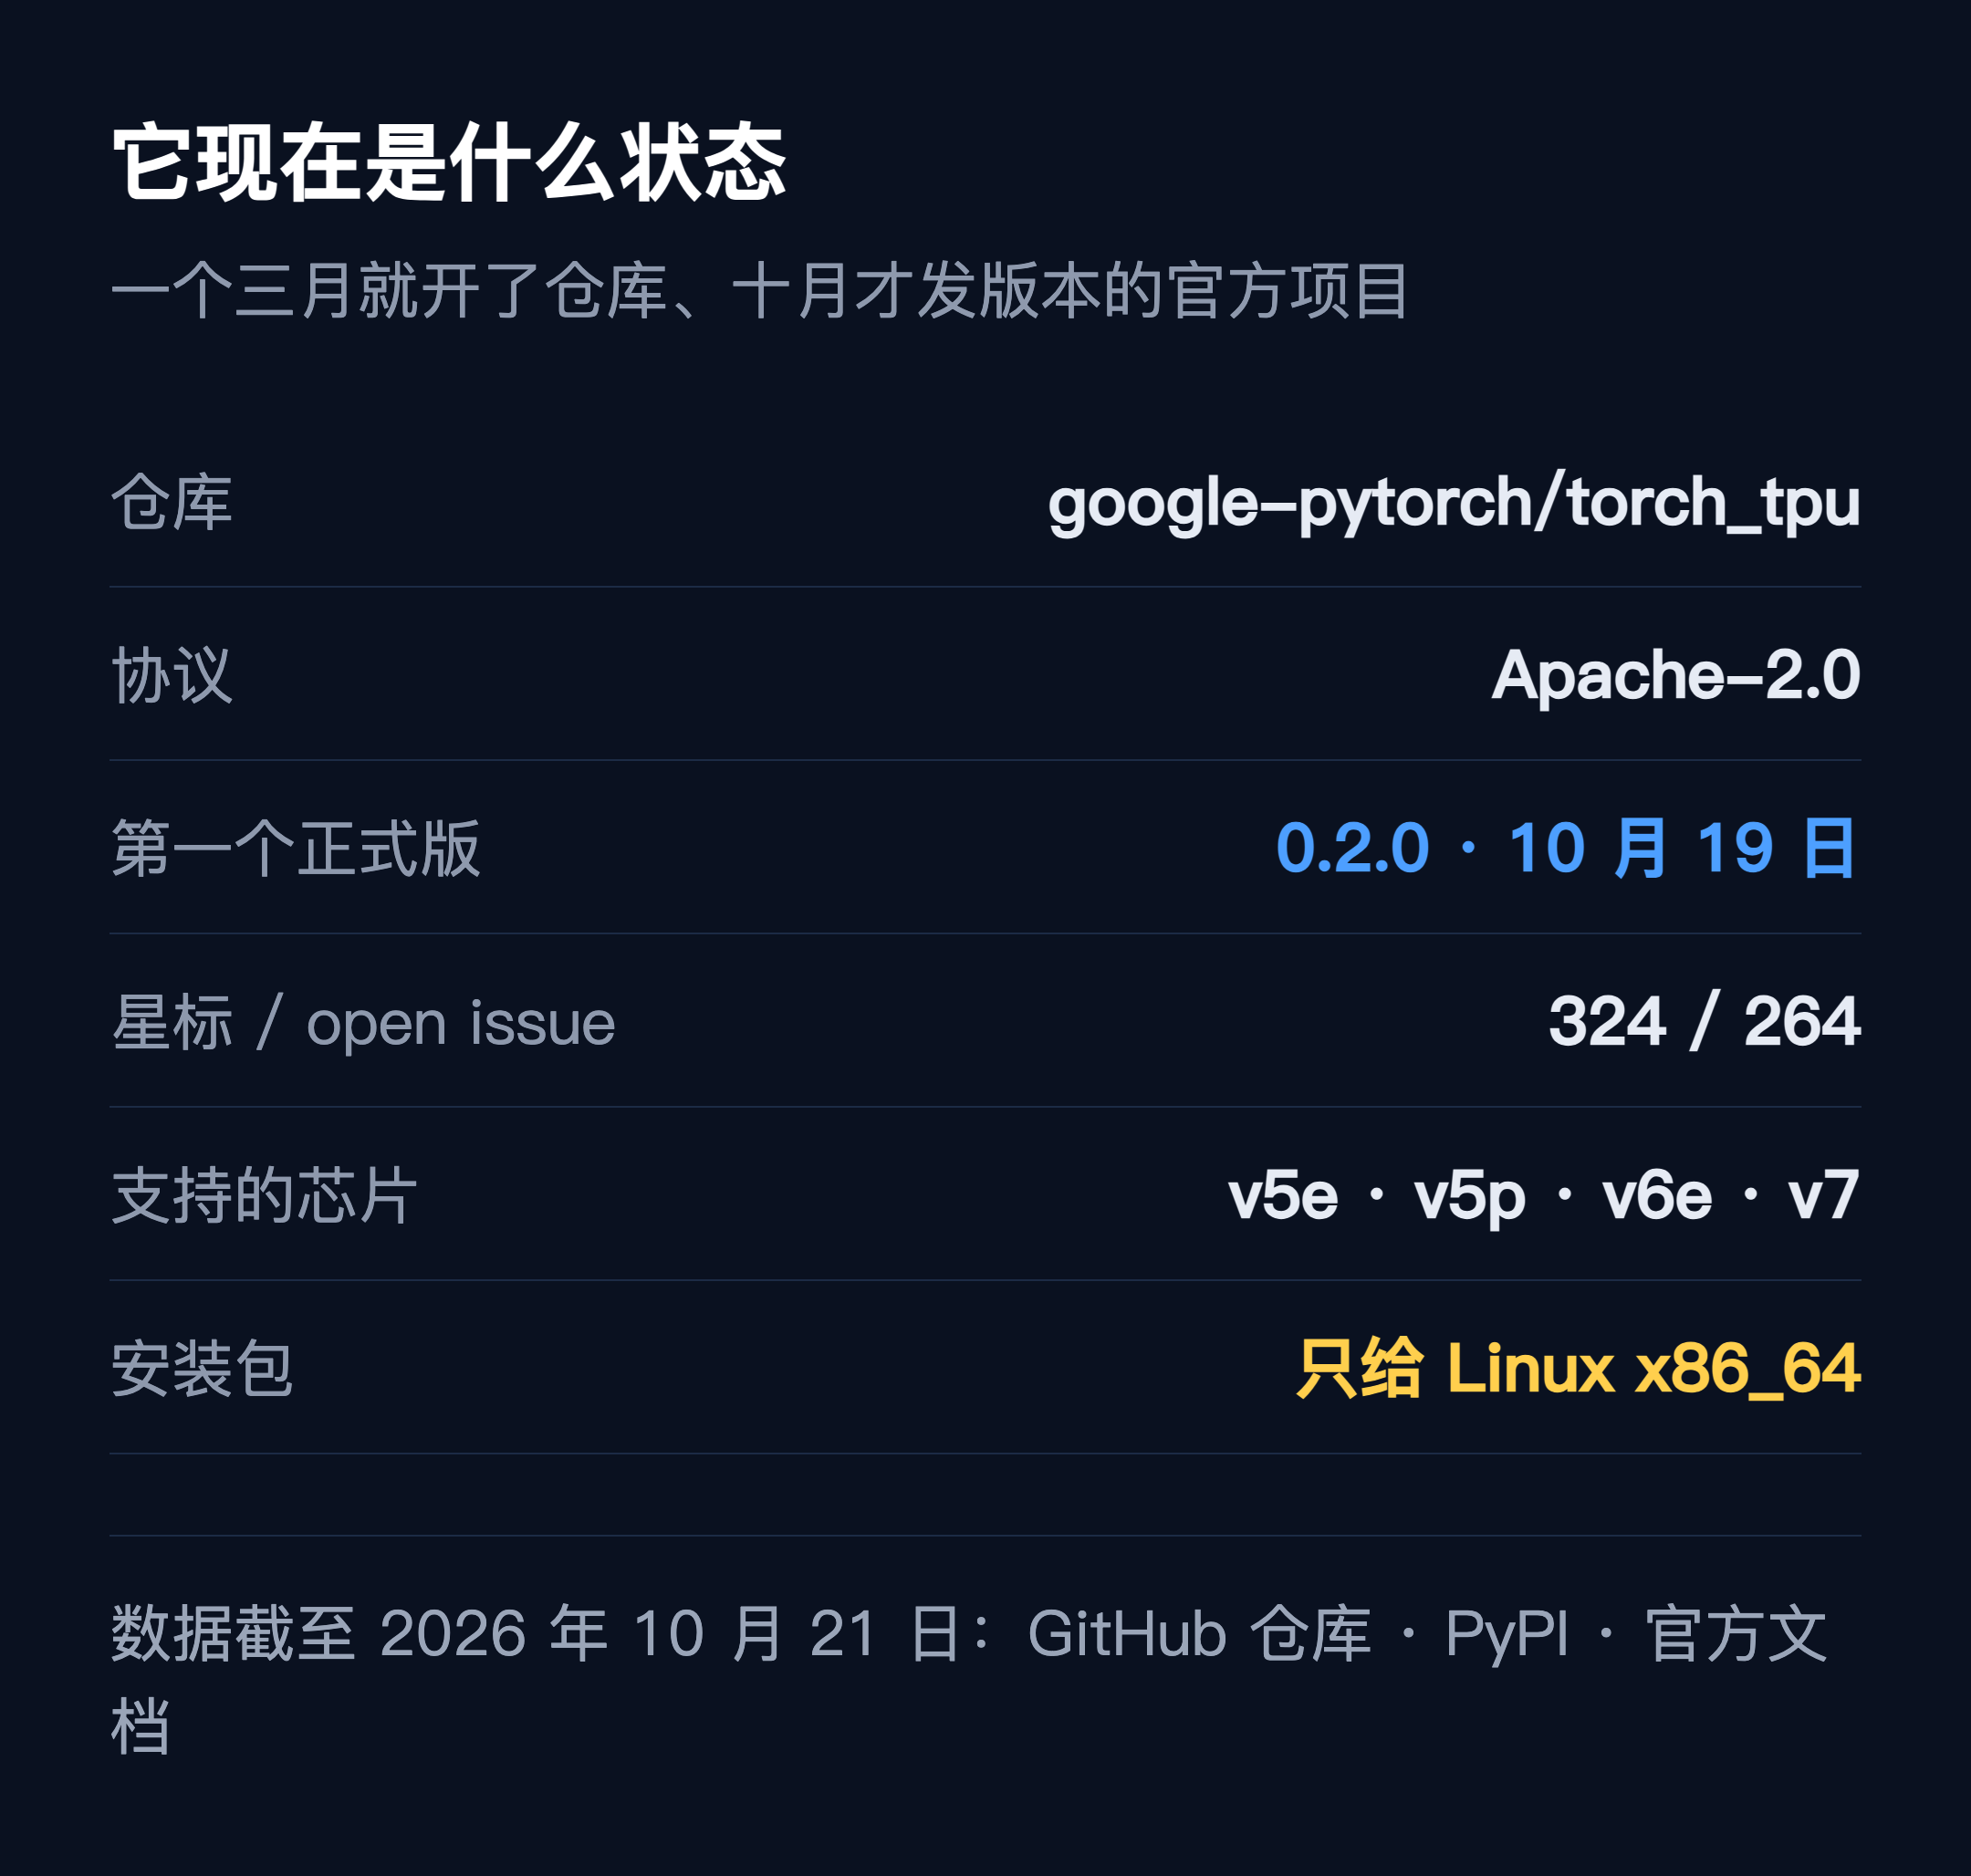
10 月 19 日,PyPI 上挂出 torch-tpu 0.2.0,五个 wheel 全是 Linux x86_64。仓库叫 google-pytorch/torch_tpu,Apache-2.0 协议。
有意思的是作者名单:Google,加上 Meta 的 PyTorch 团队。两家一起写的。
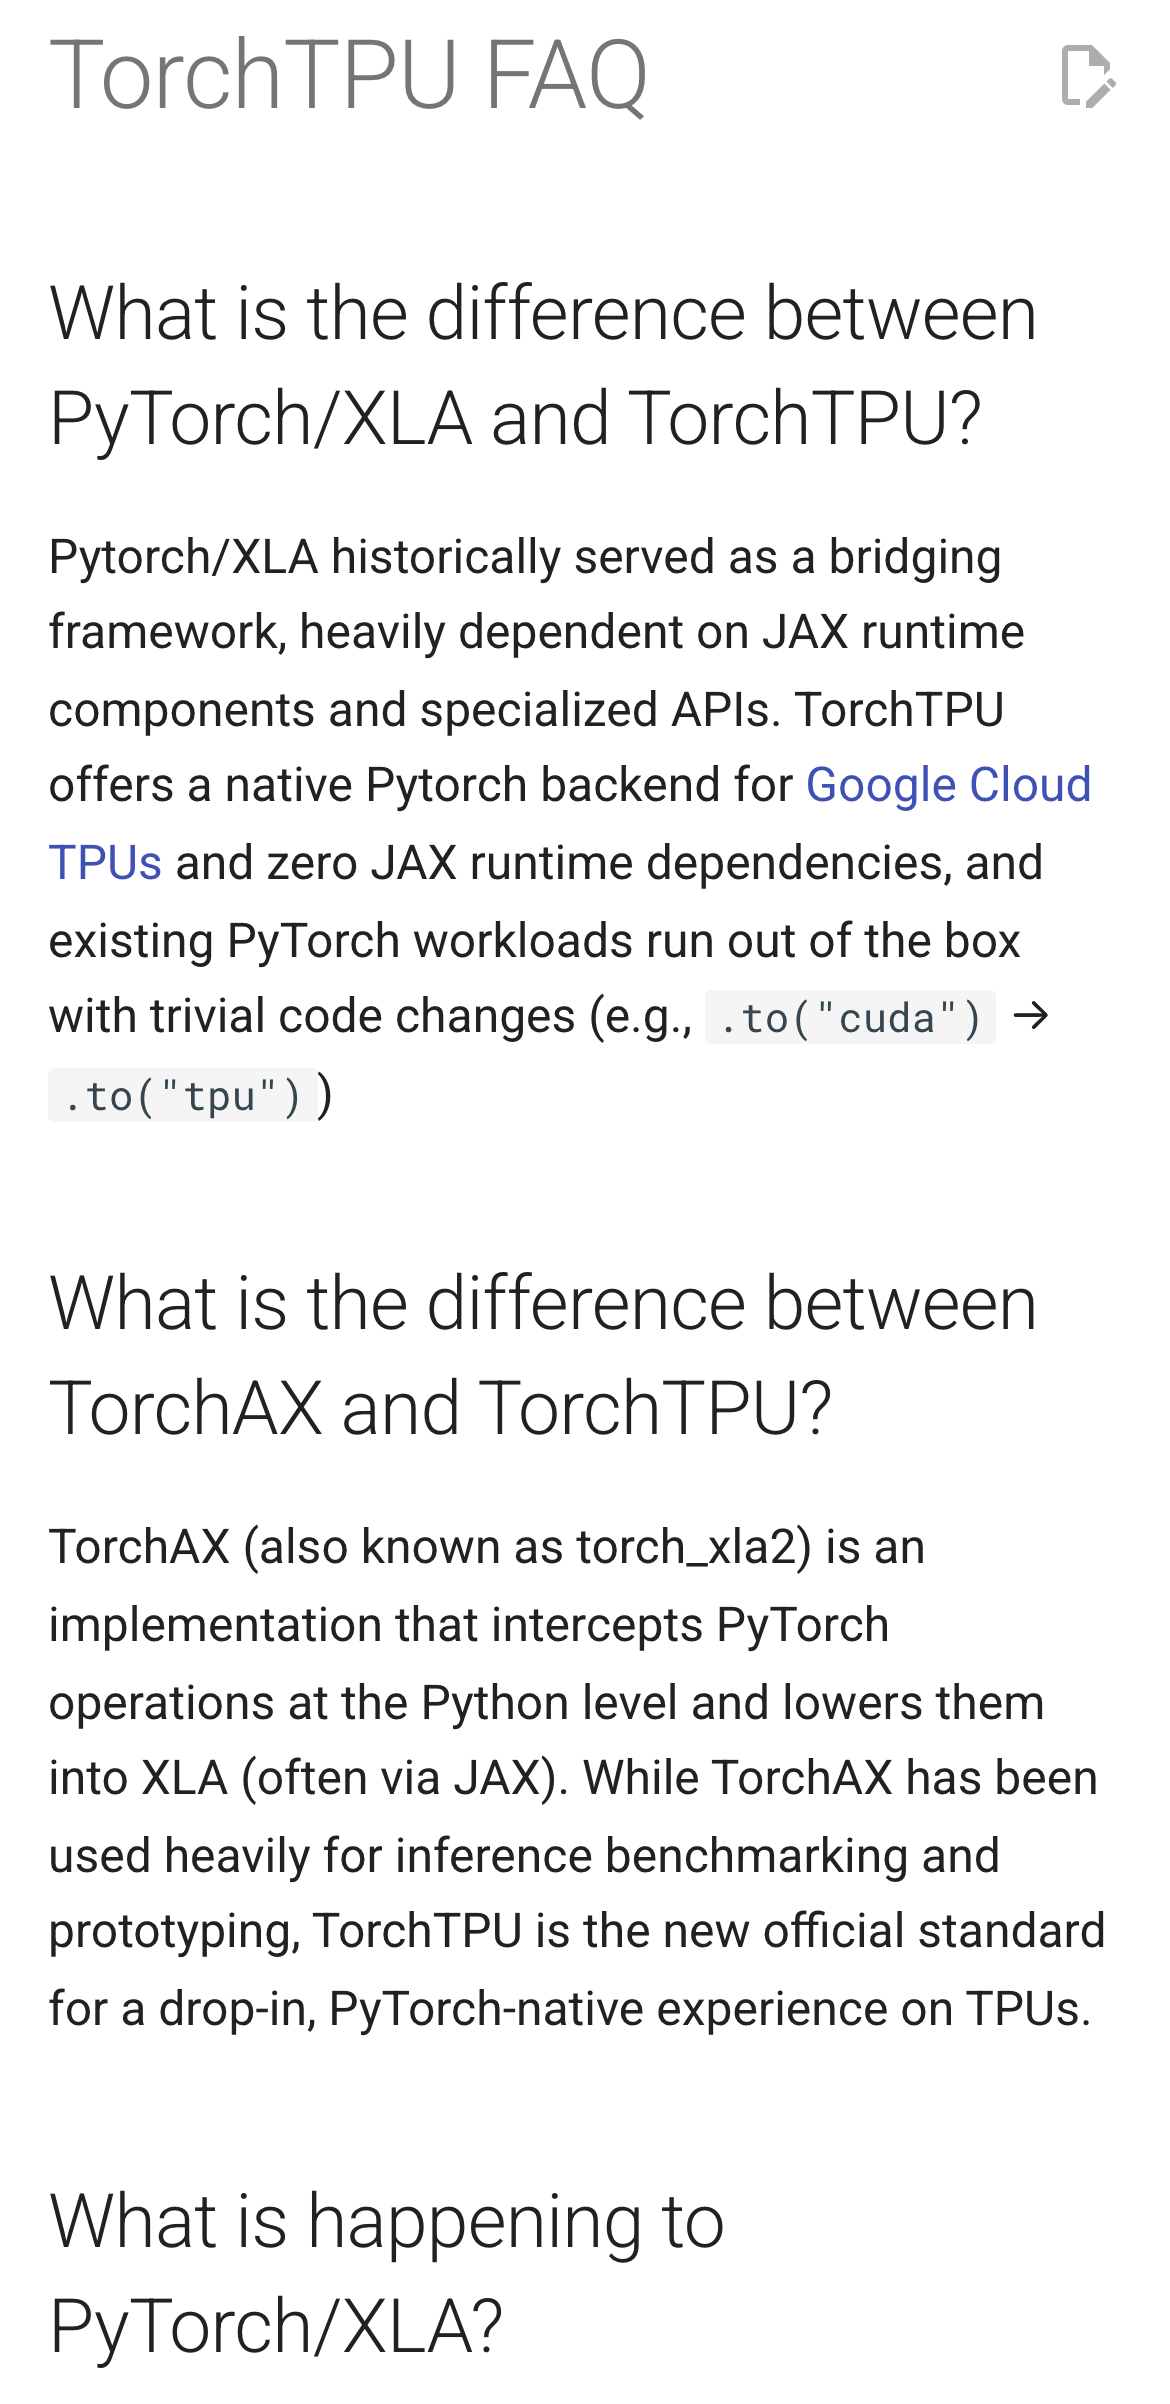
这不是又一个「把 PyTorch 转一手塞进 XLA」的中间层。官方给的定位是 native PyTorch backend,零 JAX 运行时依赖。
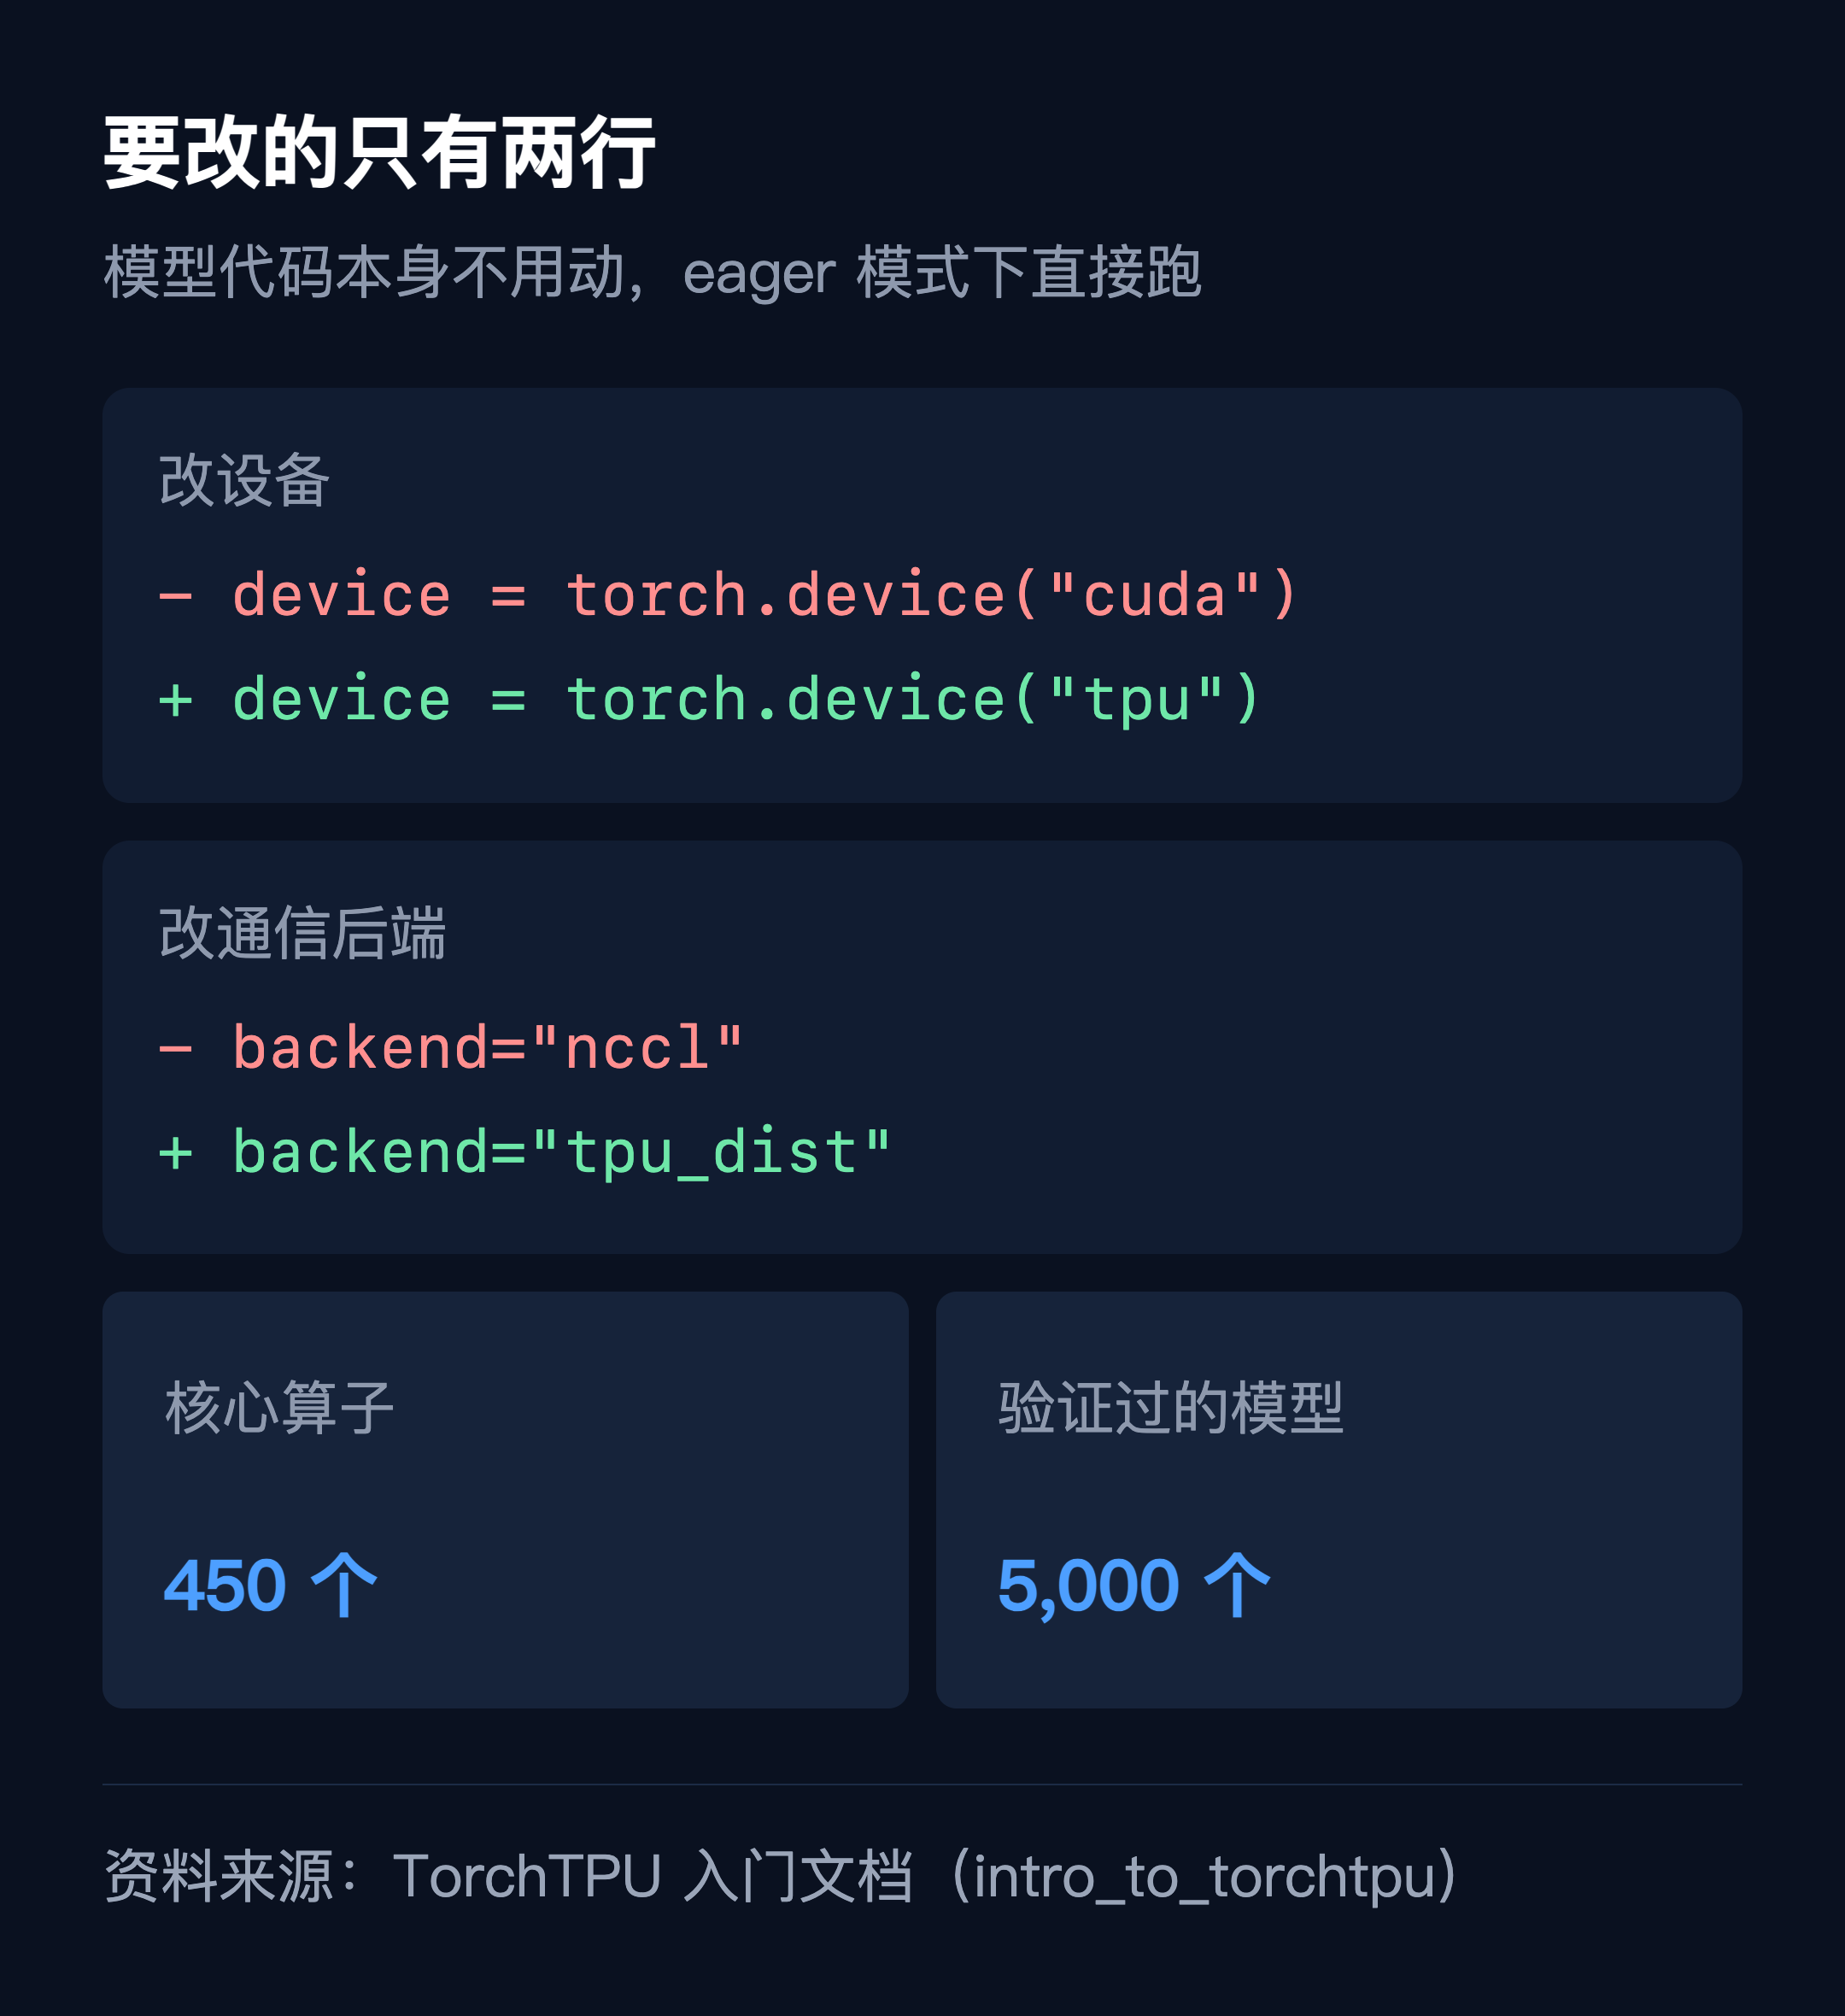
硬数字先摆两个:450 个核心 ATen 算子,前后向都齐;内部拿 5,000 个 HuggingFace 模型跑过验证。
同一份 FAQ 里还有一句更狠的:PyTorch/XLA 已被弃用,TorchTPU 接手。
一、JAX 的私产地,第一次给 PyTorch 开门
TPU 是 Google 自家的芯片,十几年来的编程入口都挂在 JAX 和 TensorFlow 这两个框架上,底下走 XLA 那套 StableHLO。
PyTorch 的用户一直被挡在门外。想上 TPU,只能走 torch_xla(PyTorch/XLA),底下压着 JAX 运行时和一套专用 API。
TorchTPU 换了个走法:注册成 PyTorch 的 PrivateUse1 后端,一行 JAX 代码都不碰。装上 wheel 再 import torch,后端自己 autoload,把 tpu 这个设备名挂进 dispatcher。
说白了,以前是拿 PyTorch 的语法写 JAX,现在 PyTorch 就是 PyTorch。
配套的两个决定也一并写进文档了:torch_xla2(TorchAX)不再是新标准;PyTorch/XLA 停止演进。老用户没得选,只能迁。
这一步等于把 TPU 生态的入口重新开了一遍。要知道,PyTorch 才是绝大多数模型的母语,JAX 写得再好也绕不开这一点。
二、改两个字符串,模型就上去了
官方给的最小迁移示例只有两处:
device = torch.device("tpu")   # 原来是 "cuda"
backend = "tpu_dist"           # 原来是 "nccl"
改完在 eager 模式下直接跑,不用先编译。报错也是 PyTorch 那套习惯,不是 XLA 编译期甩一大坨。
覆盖面上,验证过的名单里有 Llama、Qwen、Gemma、DeepSeek、Mistral,视觉的 ViT、ResNet、ConvNeXt、DINOv2。
语音那边是 Whisper、Wav2Vec2,扩散是 FLUX 和 Stable Diffusion。
不过这份名单经不起细看:官方入门页把 DeepSeek 写进去了,特性表里又把 DeepSeek、Kimi、GLM、GPT OSS 一起塞进 experimental 那栏,备注写着 hill climb,意思是还在爬坡。
三、TPU 的三个怪脾气,它挨个拆
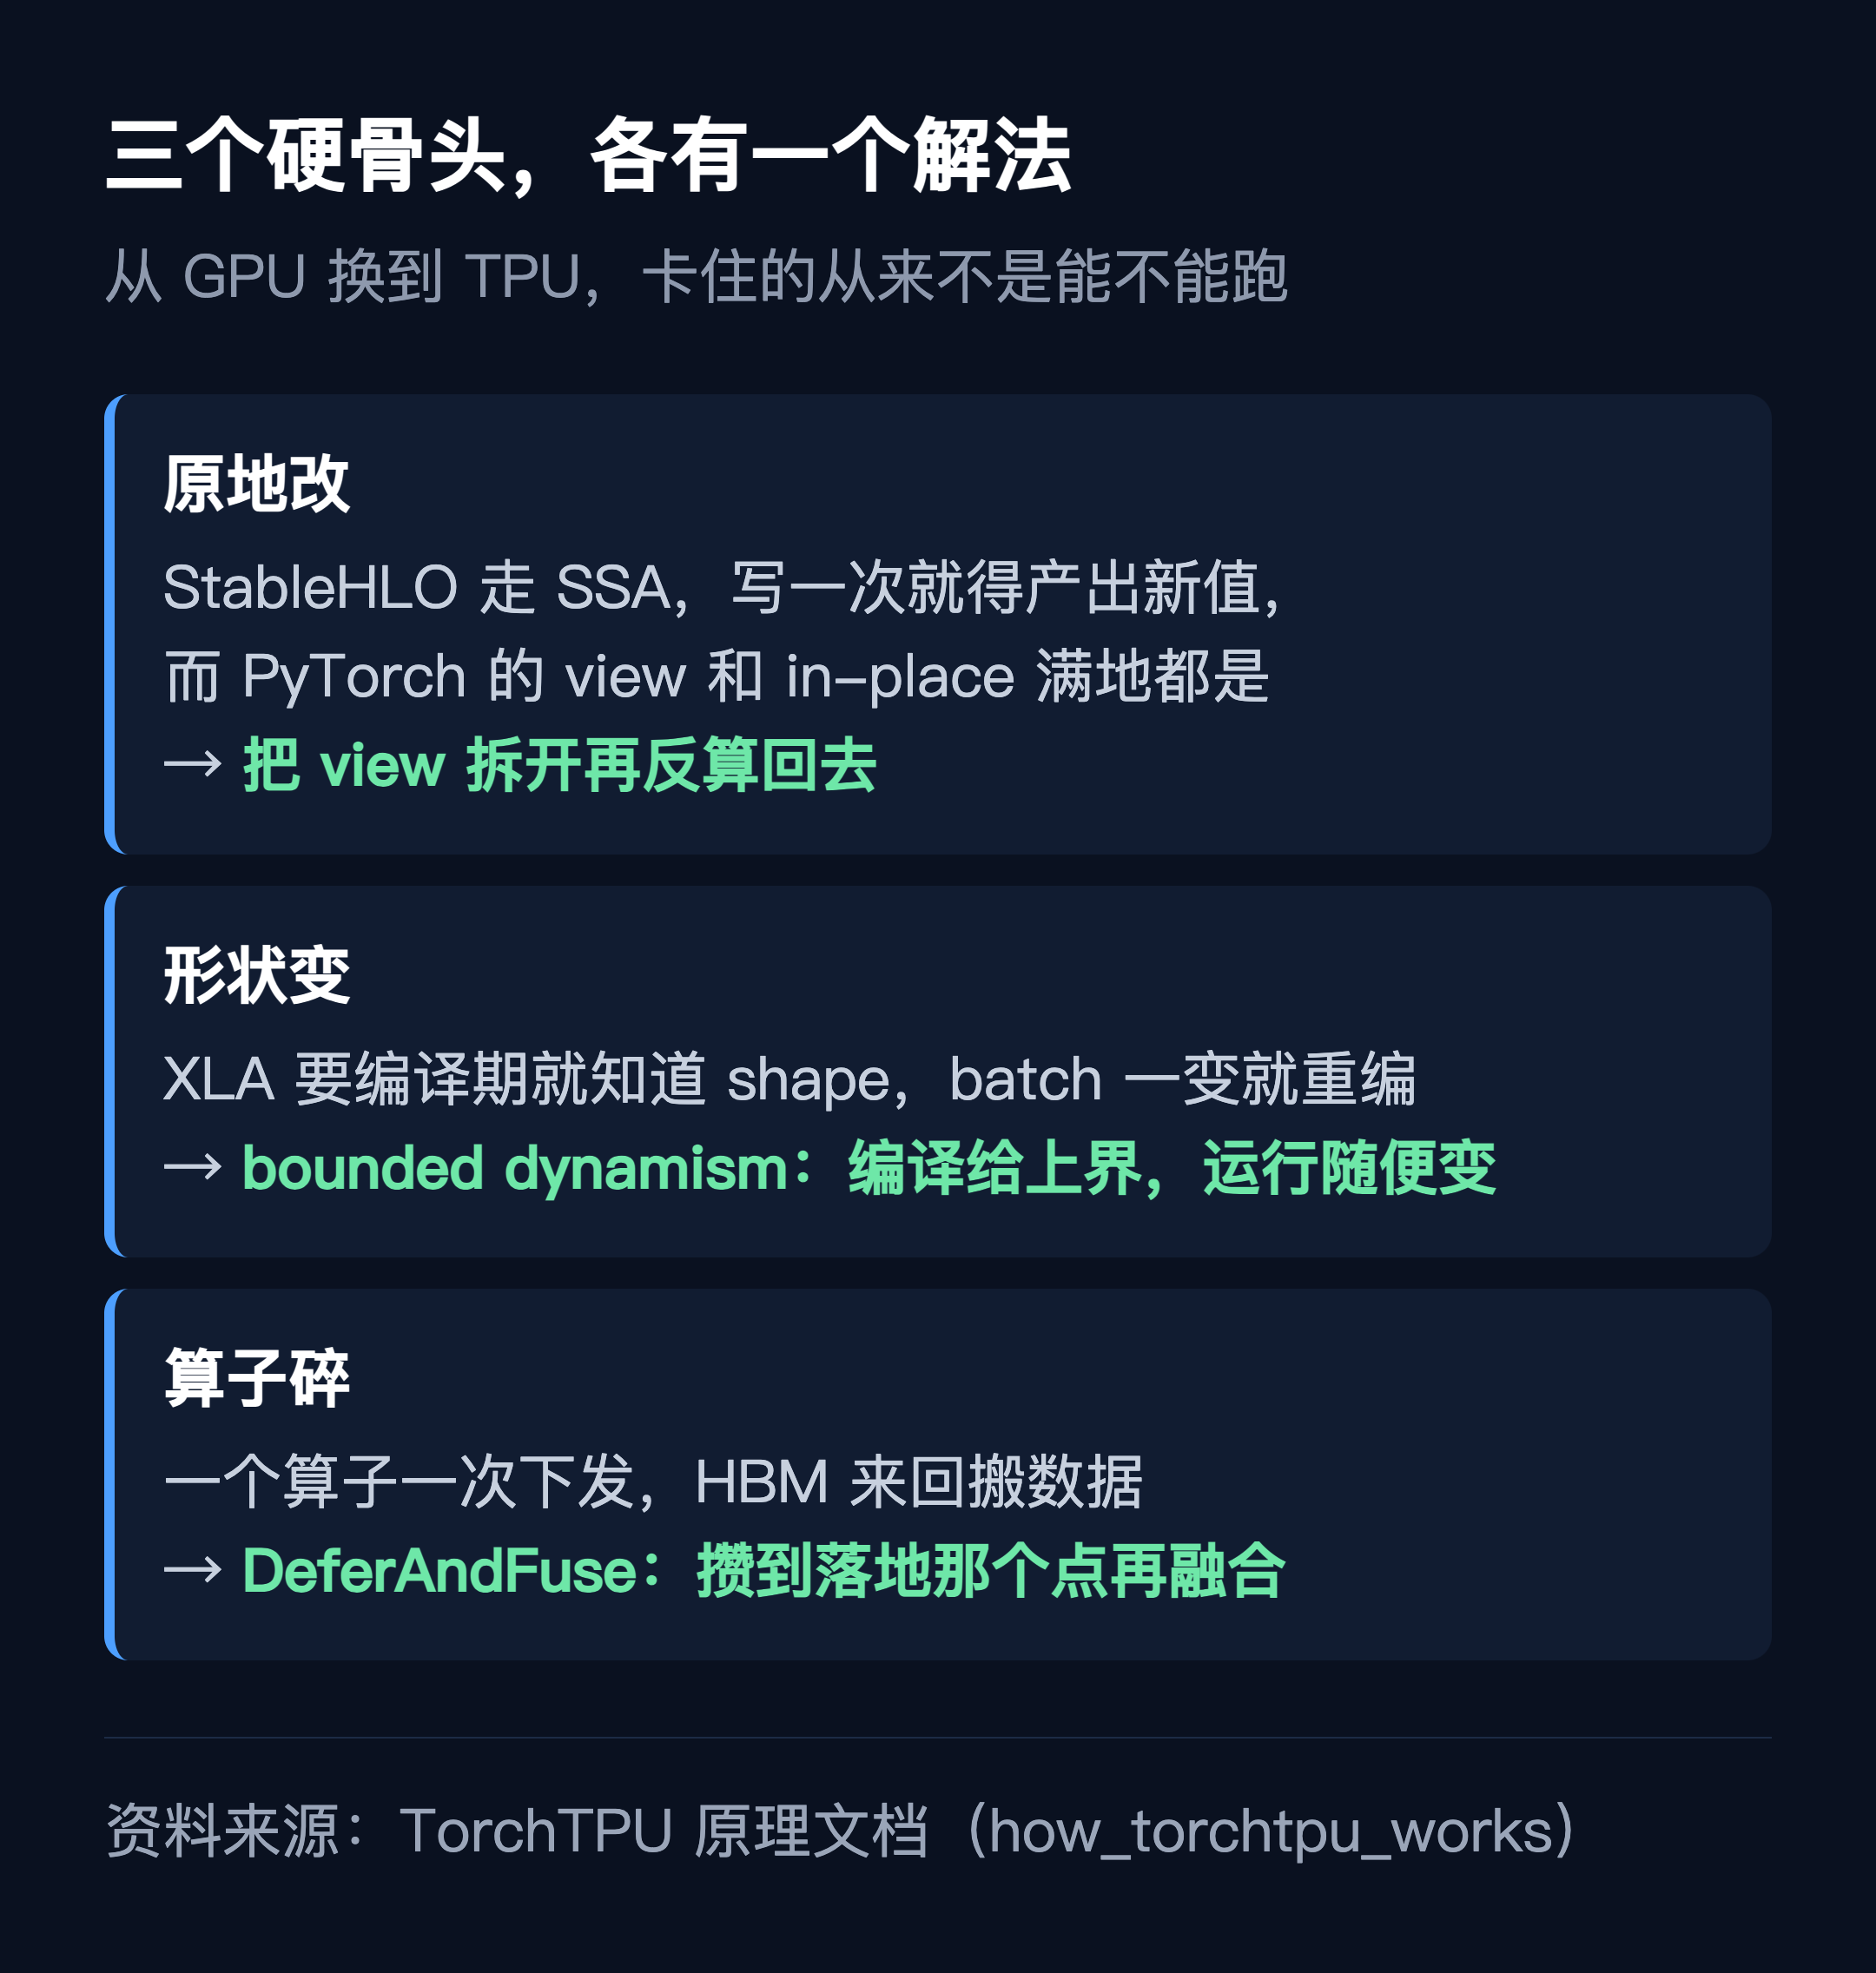
从 GPU 换到 TPU,难受的地方从来不是代码跑不起来,是跑起来不知道哪里慢。官方文档点了三处硬骨头。
头一个是原地改。StableHLO 走 SSA,一次写操作必须产出新值,而 PyTorch 的 view 语义和 in-place 操作满地都是,比如 .add_()、x[0] = 1。TorchTPU 把 view 拆开再反算回去,上层用起来跟原来一样。
这层封装的价值就在这儿:老代码不用为了 TPU 改成函数式写法。
第二个是形状。XLA 要编译期就知道 shape,batch 一变就得重编。这里加了 bounded dynamism:编译时给上界,运行时真实长度随便变。
第三个是 eager 的老毛病:一个算子一次下发,HBM 来回搬数据。
它加了个 DeferAndFuse 模式,把一串算子攒到必须落地的那个点(.cpu()、.item())再融合成一块算。
打个比方,以前每句话都单独跑一趟邮局,现在攒成一页再寄。
配套还有一套三级编译缓存:进程内存一层,同机多进程共享一层,跨机器和重启再落到对象存储一层,专门治 XLA 编译慢这个老毛病。
四、单块 v6e 上,四招叠起来是 1.46 倍
官方给了一个能算账的案例:FLUX 的 DoubleStreamBlock,训练一步含前向、loss、反向、优化器。
机器是单块 TPU v6e,32GiB HBM,序列长度 32,768。
基线 eager 是 178.61 毫秒。
四招全上,也就是零拷贝 view、融合 RoPE、Pallas SplashAttention 自定义核、torch.compile,降到 122.51 毫秒,1.46 倍。
拆开看更有意思。
只上 torch.compile 是 159.33 毫秒,1.12 倍;只上 Pallas SplashAttention 是 149.81 毫秒,1.19 倍;只上零拷贝 view 是 178.30 毫秒,等于白干。
单招收益有限,叠起来才见真章。
有个细节得说明:正文提要写的是 1.48 倍,表里最快那组算出来是 1.46,两个口径差一点,我们按表走。
而且这是单 block、单芯片、一个序列长度下的数,不是端到端训练吞吐。厂商自报,第三方还没复现。

五、怎么装,以及现在还跑不动的部分
装法两条路。
一条是 Colab:开 TPU 运行时,torch.device("tpu") 就能用,官方 quickstart 就是照这个写的。摸一摸够用。
另一条是真跑活,要 Google Cloud 的 TPU VM,机型比如 v6e:
sudo apt update && sudo apt install -y python3.12 python3.12-venv
python3.12 -m venv env && source env/bin/activate
pip install torch_tpu
要新硬件还得走 GKE,官方说那条路才够得着最近的 TPU。
代价也说清楚。
系统上,0.2.0 五个 wheel 全是 manylinux x86_64,没有 macOS 版。想在 Mac 上装,装不了。
门槛上,得先有 GCP 账号和 TPU 配额,机器按小时计费。手上没有 GCP 的,今天只能走 Colab。
成熟度上,仓库 324 星、264 个 open issue,10 月 20 日还挂着一条「BatchNorm 训练时不更新 running_mean」的 bug 报告。
分布式那块,FSDPv2 和 MPMD 官方自己标着 low perf,留在 experimental。
支持范围上,v5e、v5p、v6e(Trillium)、v7(Ironwood)能用,v8 在路线图上;推理的多机部署、P/D 分离,以及 8K 芯片以内的微调,算 validated。
还有一条限制更要命,藏在官方「已知限制」里:torch.compile 在这里默认 dynamic=False,dynamic=True 目前不能用于生产。
落到具体场景,跑 HuggingFace 模型的 decode 阶段,不开 bounded dynamism,就是每一步重编译一次。
view 语义能保住,不等于便宜。官方把 view 操作在 TPU 上的开销单列了一节内存模型来讲,第三节那套「拆开再反算」本身也要花钱。

不适合谁:只想在自己机器上跑大模型的,这条线跟你无关,本地推理那套更实在。
反过来,手上真有要上 TPU 的 PyTorch 代码,尤其是靠着 torch_xla 续命的,该动手了:PyTorch/XLA 已经停止演进,没有第二条路可走。
项目地址:https://github.com/google-pytorch/torch_tpu
文档:https://torchtpu.readthedocs.io/
安装包:https://pypi.org/project/torch-tpu/0.2.0/
评论区