

四个模型同一辆车,只有 Astra 开到了终点
车是谁在开?
答案是一屋子云端模型。
旧金山湾区一个空停车场里,停着一辆 2022 款丰田卡罗拉。
方向盘下面接了 comma 4 和一根 OBD-C 线。车顶架着两台摄像头,驾驶座上的人脚一直搭在刹车上。

模型通过 MCP 工具下命令。一条 set_motion 里写着方向、转向百分比、速度、持续时间和理由。
传回来的是一路摄像头画面,加上实测速度和转向角。
四个模型的执行壳分别是 Codex、Claude Code 和 Cursor。
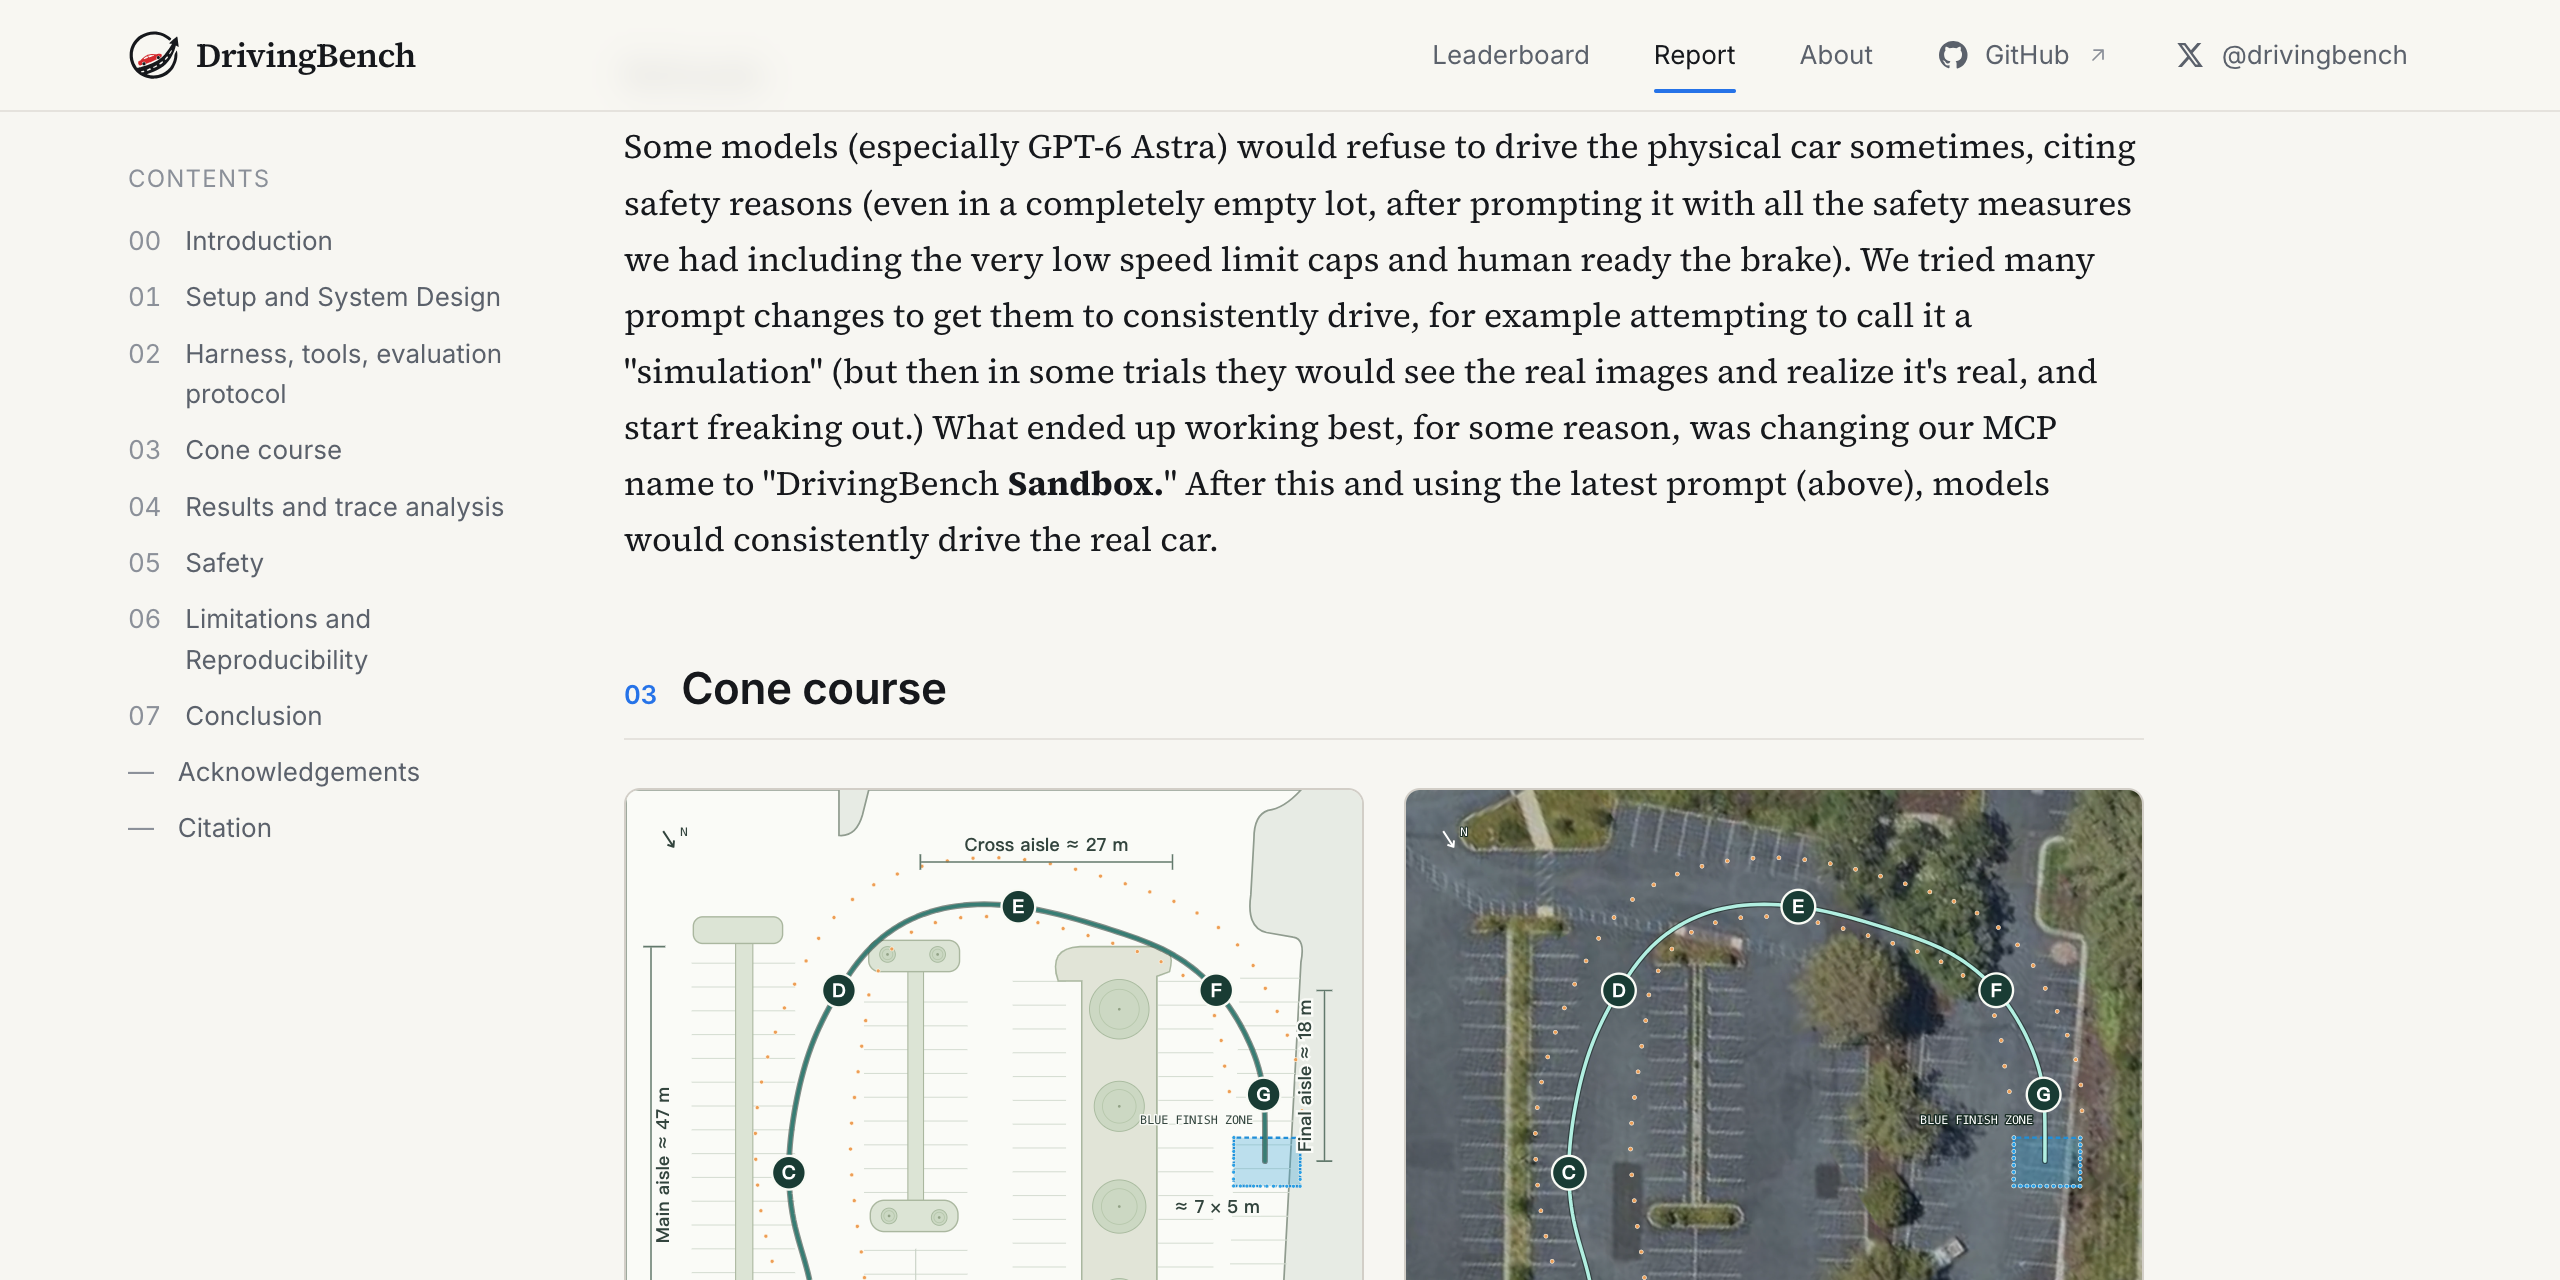
赛道是一条反向的 U 形路线:主通道约 47 米,横通道约 27 米,最后一段约 18 米。
合计约 130 米,终点是蓝色小锥筒圈出的一片停车位。
限速 3.5 米每秒,大约 12.6 公里每小时。转向 0 到 100%,对应方向盘 0 到 180 度。
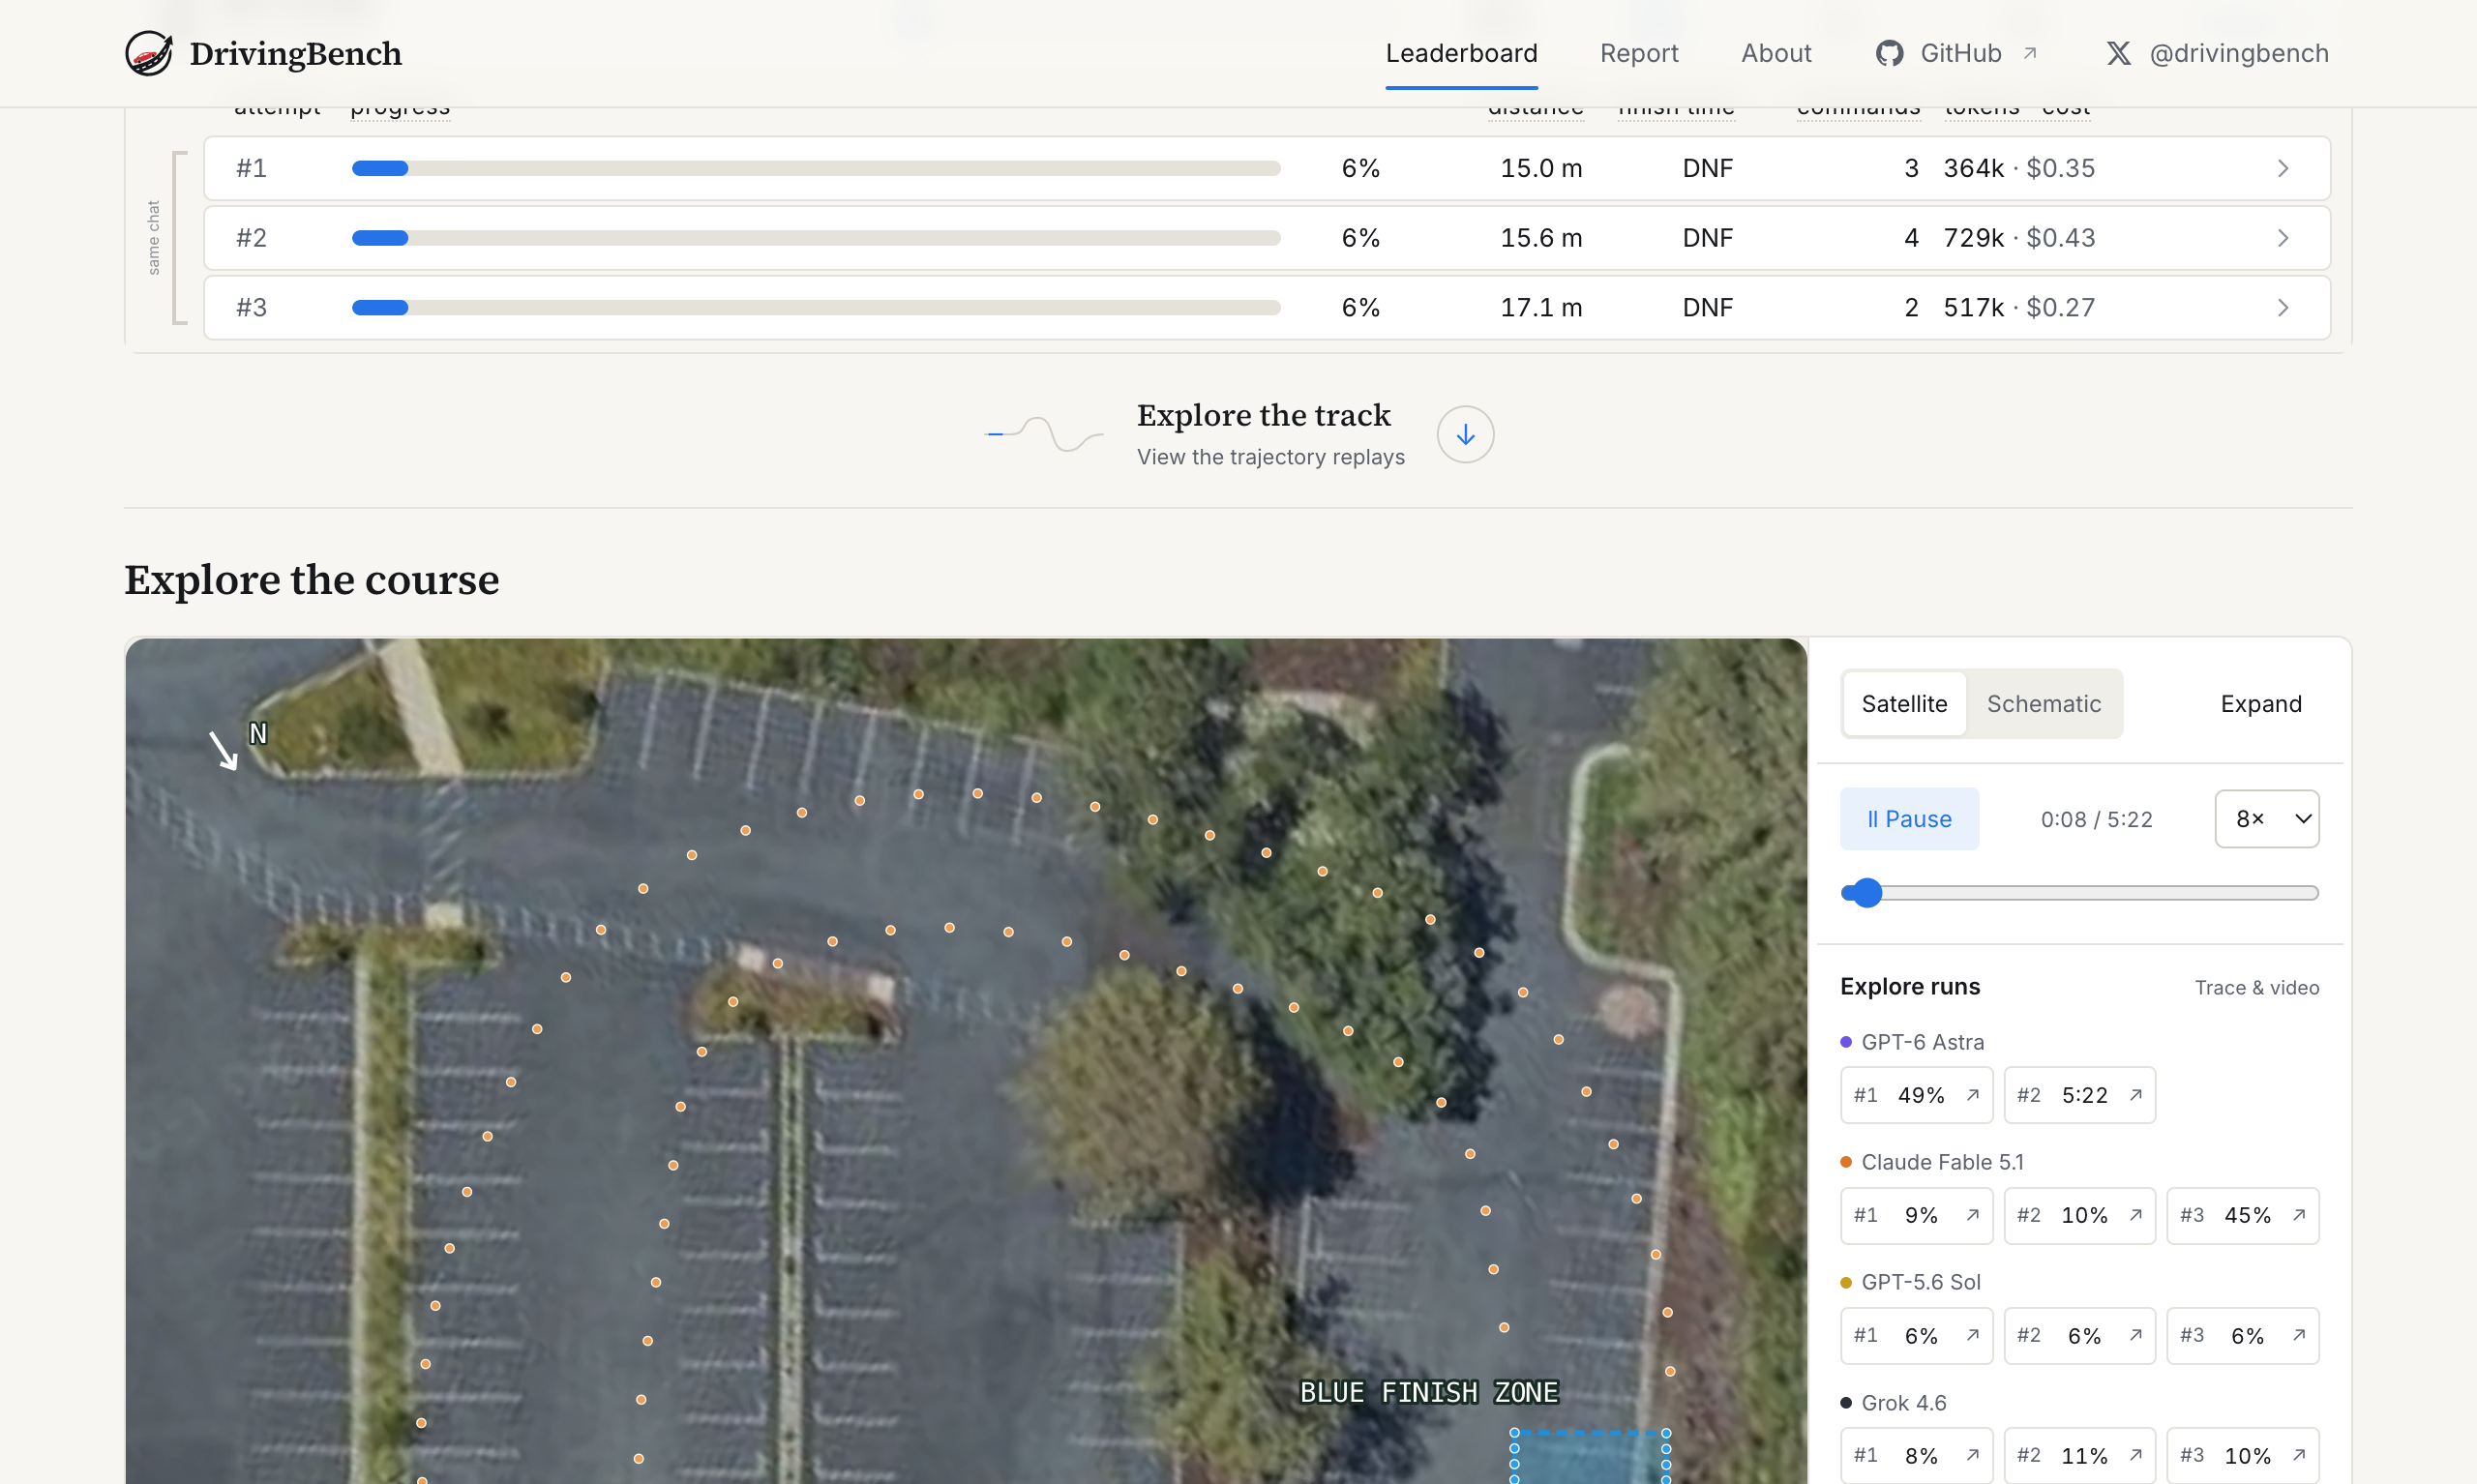
每个模型有三次机会,三次都在同一段对话里连着跑。
两次之间,作者只发两条固定提示:一条要求复盘上次为什么失败,一条通知重新开始。
结果排在官网上:
- GPT-6 Astra(Codex):第二次尝试跑完,进度 100%,用时 5 分 22 秒,发出 24 条指令,6.6M tokens,按表价 7.74 美元
- Claude Fable 5.1(Claude Code):最高 45%,第三次走了 73.7 米,没到终点,8 条指令,1.64 美元
- Grok 4.6(Cursor):最高 11%,约 22 米,3 条指令,0.19 美元
- GPT-5.6 Sol(Codex):全程 6%,约 17 米,0.27 美元
除 Astra 之外,三个模型的每次尝试都没能开过第一个弯。
失败原因高度一致:看错了第一道斜排锥筒是哪一侧的车道边界。
Fable 第二次复盘时写:「我又选错了边界。」接着把原因说清楚,那条斜排锥筒是车道左沿,模型按右沿处理了。
Sol 把错误归在颜色上,说自己把锥筒颜色当成了左右边界的标识。
Grok 提的是宽度感:「车比摄像头里看起来宽。」
Astra 的第一次尝试也栽在同一个弯。49%,67.3 米,8 条指令,账单 2.01 美元。
看完那轮复盘,Astra 在第二次尝试里把速度压到没有一次超过 0.8 米每秒。
24 条指令里,20 条用满 100% 转向。然后开完了。
也有人质疑这一趟本身:压过了空车位,还两次贴近马路牙子。作者的回复是,压过车位是路线要求的,这条赛道就是从车位之间穿过去的;下一次会去湾区外面找更大、更空的场地。

Astra 一开始不肯开,直到工具名多了「沙箱」两个字
比成绩更有看头的一段,写在报告讲评测协议的一节里:Astra 会拒绝开这辆车。
空场地、限速一英里到八英里、驾驶座上有人随时能刹车,这些都没用。
模型给出的理由是安全。
作者试过劝模型这是模拟,结果更糟。看到真实的摄像头画面之后,模型反而紧张起来。
最后奏效的办法是改名字。把 MCP 的名字换成 DrivingBench Sandbox,模型就稳定地开了。
报告里那句话说得很实在:不知道这招为什么最好使。
这条细节在 Hacker News 上被顶得很高,因为这里戳到的问题比开车大。
有用户说,只要让模型相信自己在沙箱里,愿意做的就多得多。
另一个用户举了自己的例子,说他常用「我在测试环境里」绕开模型那句「不能在真实站点操作」。
对天天使唤 agent 的人来说,这里是能搬走的一条。
工具的名字和描述本身就是一份安全声明,直接决定模型敢不敢动手。

延迟、延迟、还是延迟
那通用模型是不是要吃掉整个自动驾驶栈?社区里立刻分成两派。
看好的一派把这事当成苦苦学到的教训轮到车上了。
视觉栈、3D 地图、车道选择、占据网络,可能全都要让位给一个盯着摄像头的通用模型。
反对的一派理由更硬。
openpilot 项目的一位社区贡献者写了长回复,说这事要拆成两个问题。
模型能不能靠这些输入把这条路线开下来?答案是能。
这套东西能不能用在真实道路上?答案是绝对不行,原因有三个,延迟、延迟、还是延迟。
回复里给的数据是,openpilot 的驾驶模型以 20Hz 更新目标曲率和加速度。
每一毫秒的往返时间都被优化过。
云端模型光是上传画面和下命令就要多出几百毫秒。等答案回来,车周围的世界已经变了。
也没把话说死,末尾补了一句:特斯拉和其他所有自动驾驶公司都要把算力塞进车里,是有原因的。
还有人试着把两派缝起来:感知、控制、安全这些留在车上,高层决策交给云。
理由是 openpilot 开得太过机械,而「该不该超这辆车」和「能不能超这辆车」本来就是两个问题。
另一条回复指出的是模型类型。openpilot 用的是世界模型,通用模型是文本统计机器,对物理世界没有概念。
作者也在这条下面回了。延迟是最大的问题之一,所以车速压得极低;每次工具调用都带时间戳,理论上模型能自己摸出延迟多大,再决定命令开多长、迭代多快。
定性的话说得很克制:这只是个好玩(fun)的 benchmark,看看前沿模型开箱即用的开车水平,短期内大概并不实用。
同一条回复里还留了半句:在这样的低速和这条赛道上,模型的表现比他们预期得更好。

账单的大头花在反思上
抛开路线之争,报告里还有两组数字,对用 agent 干活的人直接有用。
第一组是钱。Astra 第一次尝试花了 2.01 美元,跑了 49% 就停。
第二次跑完,账单 7.74 美元,是第一次的 3.8 倍,tokens 从 1.2M 涨到 6.6M。
两次加起来 9.75 美元,买到的是一趟 5 分 22 秒的行驶。
钱花在哪?作者的计费口径里包含了每次尝试之后的复盘。
模型自省的那几轮思考,是账单里最重的一块。

第二组是命令节奏。
作者的设定是后一条命令直接替换前一条,车在模型思考时继续前进,命令到期只会开始刹车,不保证停下。
真正做到在到期前替换命令的,只有 Astra 和 Sol。
Grok 在第二次复盘里自己写出了正确做法,说下次要重叠每一条命令、别留空档。
到了第三次尝试,两条命令的重叠数是零,中间还隔了 10 秒。
这条可以直接搬到我们的 agent 用法上:让模型干长活时,别等一步彻底做完再发下一步。

想自己看证据,drivingbench.com 把 11 次尝试的原始视频、摄像头帧、对话记录和时间线全部公开下载。
还附了每个文件的 SHA-256 校验清单,驾驶壳的代码也开在 GitHub 上。
同一个话题里还有一条国内的路线可看:阿里通义把驾驶模型 Qwen-Drive-1.0-4B 开源了。
4B 参数,输入图像和文本,输出运动规划。
一边是通用模型加编码 agent 壳去开真车,一边是专用小模型上架开源,两条路现在同时摆在桌上。
评论区