

10 月 19 日,Inception Labs 放出 Mercury 3。
这家公司的模型不按顺序吐字,先把一整片文本铺开,再一轮轮往回收。
官方数字是每秒 1,068 个 token。
同样按 medium 档推理力度比,GPT-6 Luna 约 130,Claude Haiku 5.5 约 240。快 4 到 8 倍。
跑分也没塌。官方那张表里 12 项能力测试,赢了 8 项。
GDPval 的 Elo 打到 1,237.2,Luna 是 1,204.0,Haiku 5.5 是 1,225.0。
价格上市打五折:输入 $0.10、输出 $0.35,按每百万 token 算。
折后比对手便宜三成。折扣是上市期的,不会一直都在。
今天就能调。官方 API、OpenRouter、Vercel 都通,Baseten 得单独申请。
接口和 OpenAI 兼容,新 key 送一亿 token。
真正值钱的信息不在发布页上。Hacker News 的帖子里,创始人自己下去回帖,把话说小了一半。

快 4 到 8 倍:不再一个字一个字往外蹦
自回归模型写到第 1000 个字时,前 999 个已经钉死了,错了也只能顺着往下圆。
扩散模型换个姿势:先铺一版草稿,再整片整片地改。

官方管这个过程叫从粗到细。落到算力上,一批位置并行着算,不用一步一推。
Inception 在自家关于页上写了句大白话:AI 不该像单向打字机,该像编辑。
这句是他们原话,不是我翻的。
要知道,这条路以前一直被当偏门。扩散做图早就能出活,做文本总卡在质量上——能快,但答不准,所以没人当主力。
Mercury 3 想证的是另一半。从第一代到现在,总参数翻了 40 倍,官方说智能涨了 3 倍,速度没掉。

二十个月五代,每一代都比当时同档对手快 4 到 10 倍。
这条线要是站得住,扩散就有了另一条跟自回归并排跑的路,不再只是个「快一点的备胎」。
十二项跑分赢八项,输的四项卡在记性和硬编程上
赢的地方很集中。
指令遵循 IFBench,76.84 对 61.82 和 54.65;银行场景的 τ³-bench,30.24 对 23.00 和 13.06。
SWE-Bench Atlas 51.08 对 33.33 和 32.26。这几项差得不算小。

输的四项有共性。
AA-Omniscience 考的是「知不知道」,46.44,就差 Luna 半口气。
AA-LCR 和 MRCR v2 考长文里捞信息,分别输给 78.30 和 78.40;DeepSWE 是硬编程,46.31 对 Haiku 的 51.62。
差距都不大,最大那项也就 5 分多。
但方向清楚:越是要把整本书记住再翻出来、越是要在复杂代码里走窄路的活,越吃亏。
这张表还有个前提得看清。
三家全是 medium 档,没有 low 到 max 的曲线,也没有任务完成时间。
创始人自己在评论区把话说小了一半
帖子里第一个长回复,来自 Inception 联合创始人兼首席科学家 Volodymyr。
他先把官方口径复述一遍,然后给了个结论:扩散能 scale。

被问到 DeepSWE 那 6 分差距时,他答得很实在。
说不清具体原因,日常用下来就是 Haiku 或 Luna 的水平,还替不了 Opus、Fable 那种主模型,拿来跑 subagent 可以。
顺带抖了个细节。他们拿大模型给出的 kernel 优化思路喂给 Mercury 3 去实现,改进了生产环境,他自己管这叫 RSI 的一种。
反应分两拨。
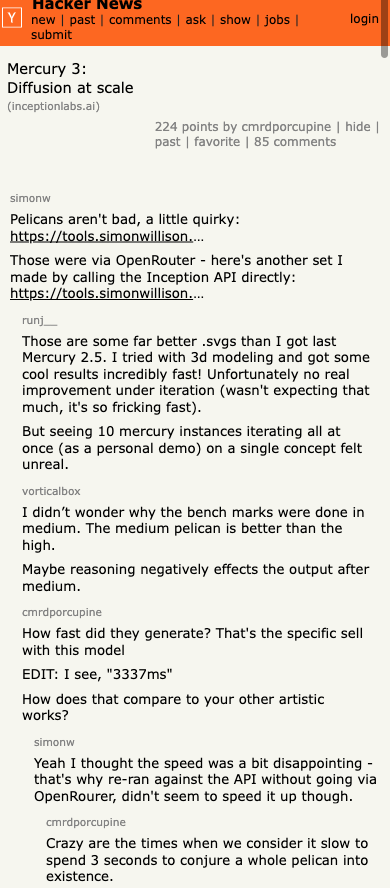
Simon Willison 用他惯常的鹈鹕测试跑了一遍,画的是一只骑自行车的鹈鹕,结论是比上一代好太多,「3D 建模也跑出了些挺酷的东西,快得离谱」。
挑刺的那拨也直接。
有人实测后说速度「有点失望」,绕开 OpenRouter 直连 API 也没快多少。
有人问为什么不放权重,创始人回「暂时不放」,对面就一句「那祝你好运」。
问得最狠的是 batch size。
Google 的研究里,扩散模型的速度优势在大 batch 下会掉,那位直接要 H100 上的实测数字。
创始人回的是「我们对扩展性满意」,没给数。
说到底,这些追问都冲着同一件事:1,068 tok/s 是 API 上的读数,塞进真实批处理还能剩多少,眼下没人知道。
五折是限时的,恢复原价反而比对手贵
价格这栏值得单独算一遍。
原价是输入 $0.20、输出 $0.70;GPT-6 Luna 和 Haiku 5.5 都挂在 $0.10/$0.50。

五折一停,输出比对手贵 40%,输入贵一倍。
缓存命中按输入价的一折收,折后 $0.01、原价 $0.02,高频重试的 agent 最吃这一口。
现在切过去,等于押一个期限未知的折扣。页面只写了 50% OFF,没写哪天结束。
还有个更硬的信号。Mercury 2 和 2.5 已经对新用户停售,老客户用到 11 月 15 日。
上一代 9 月 8 日发布,这一代 10 月 19 日跟上,六周。
官方在评论区答应,第三方复测后会补上任务完成时间和更多场景的数据。
等那些数字落地,「每秒一千个 token」到底值多少钱才有得算。
眼下能确认的只有一件事:扩散模型不再是那个只跑得快、答不准的选项了。
评论区