

正反顺序各问一遍,两遍都对才算过。所以瞎猜的底分是 25。
这份卷子叫 Taste-Bench,出自香港城市大学和微软的一支小队。
一作潘文博在城大,脚注里留了一句:这份工作是在微软实习期间完成的。
9 月 22 日挂上 arXiv,预印本,还没人拿数据集复测过。
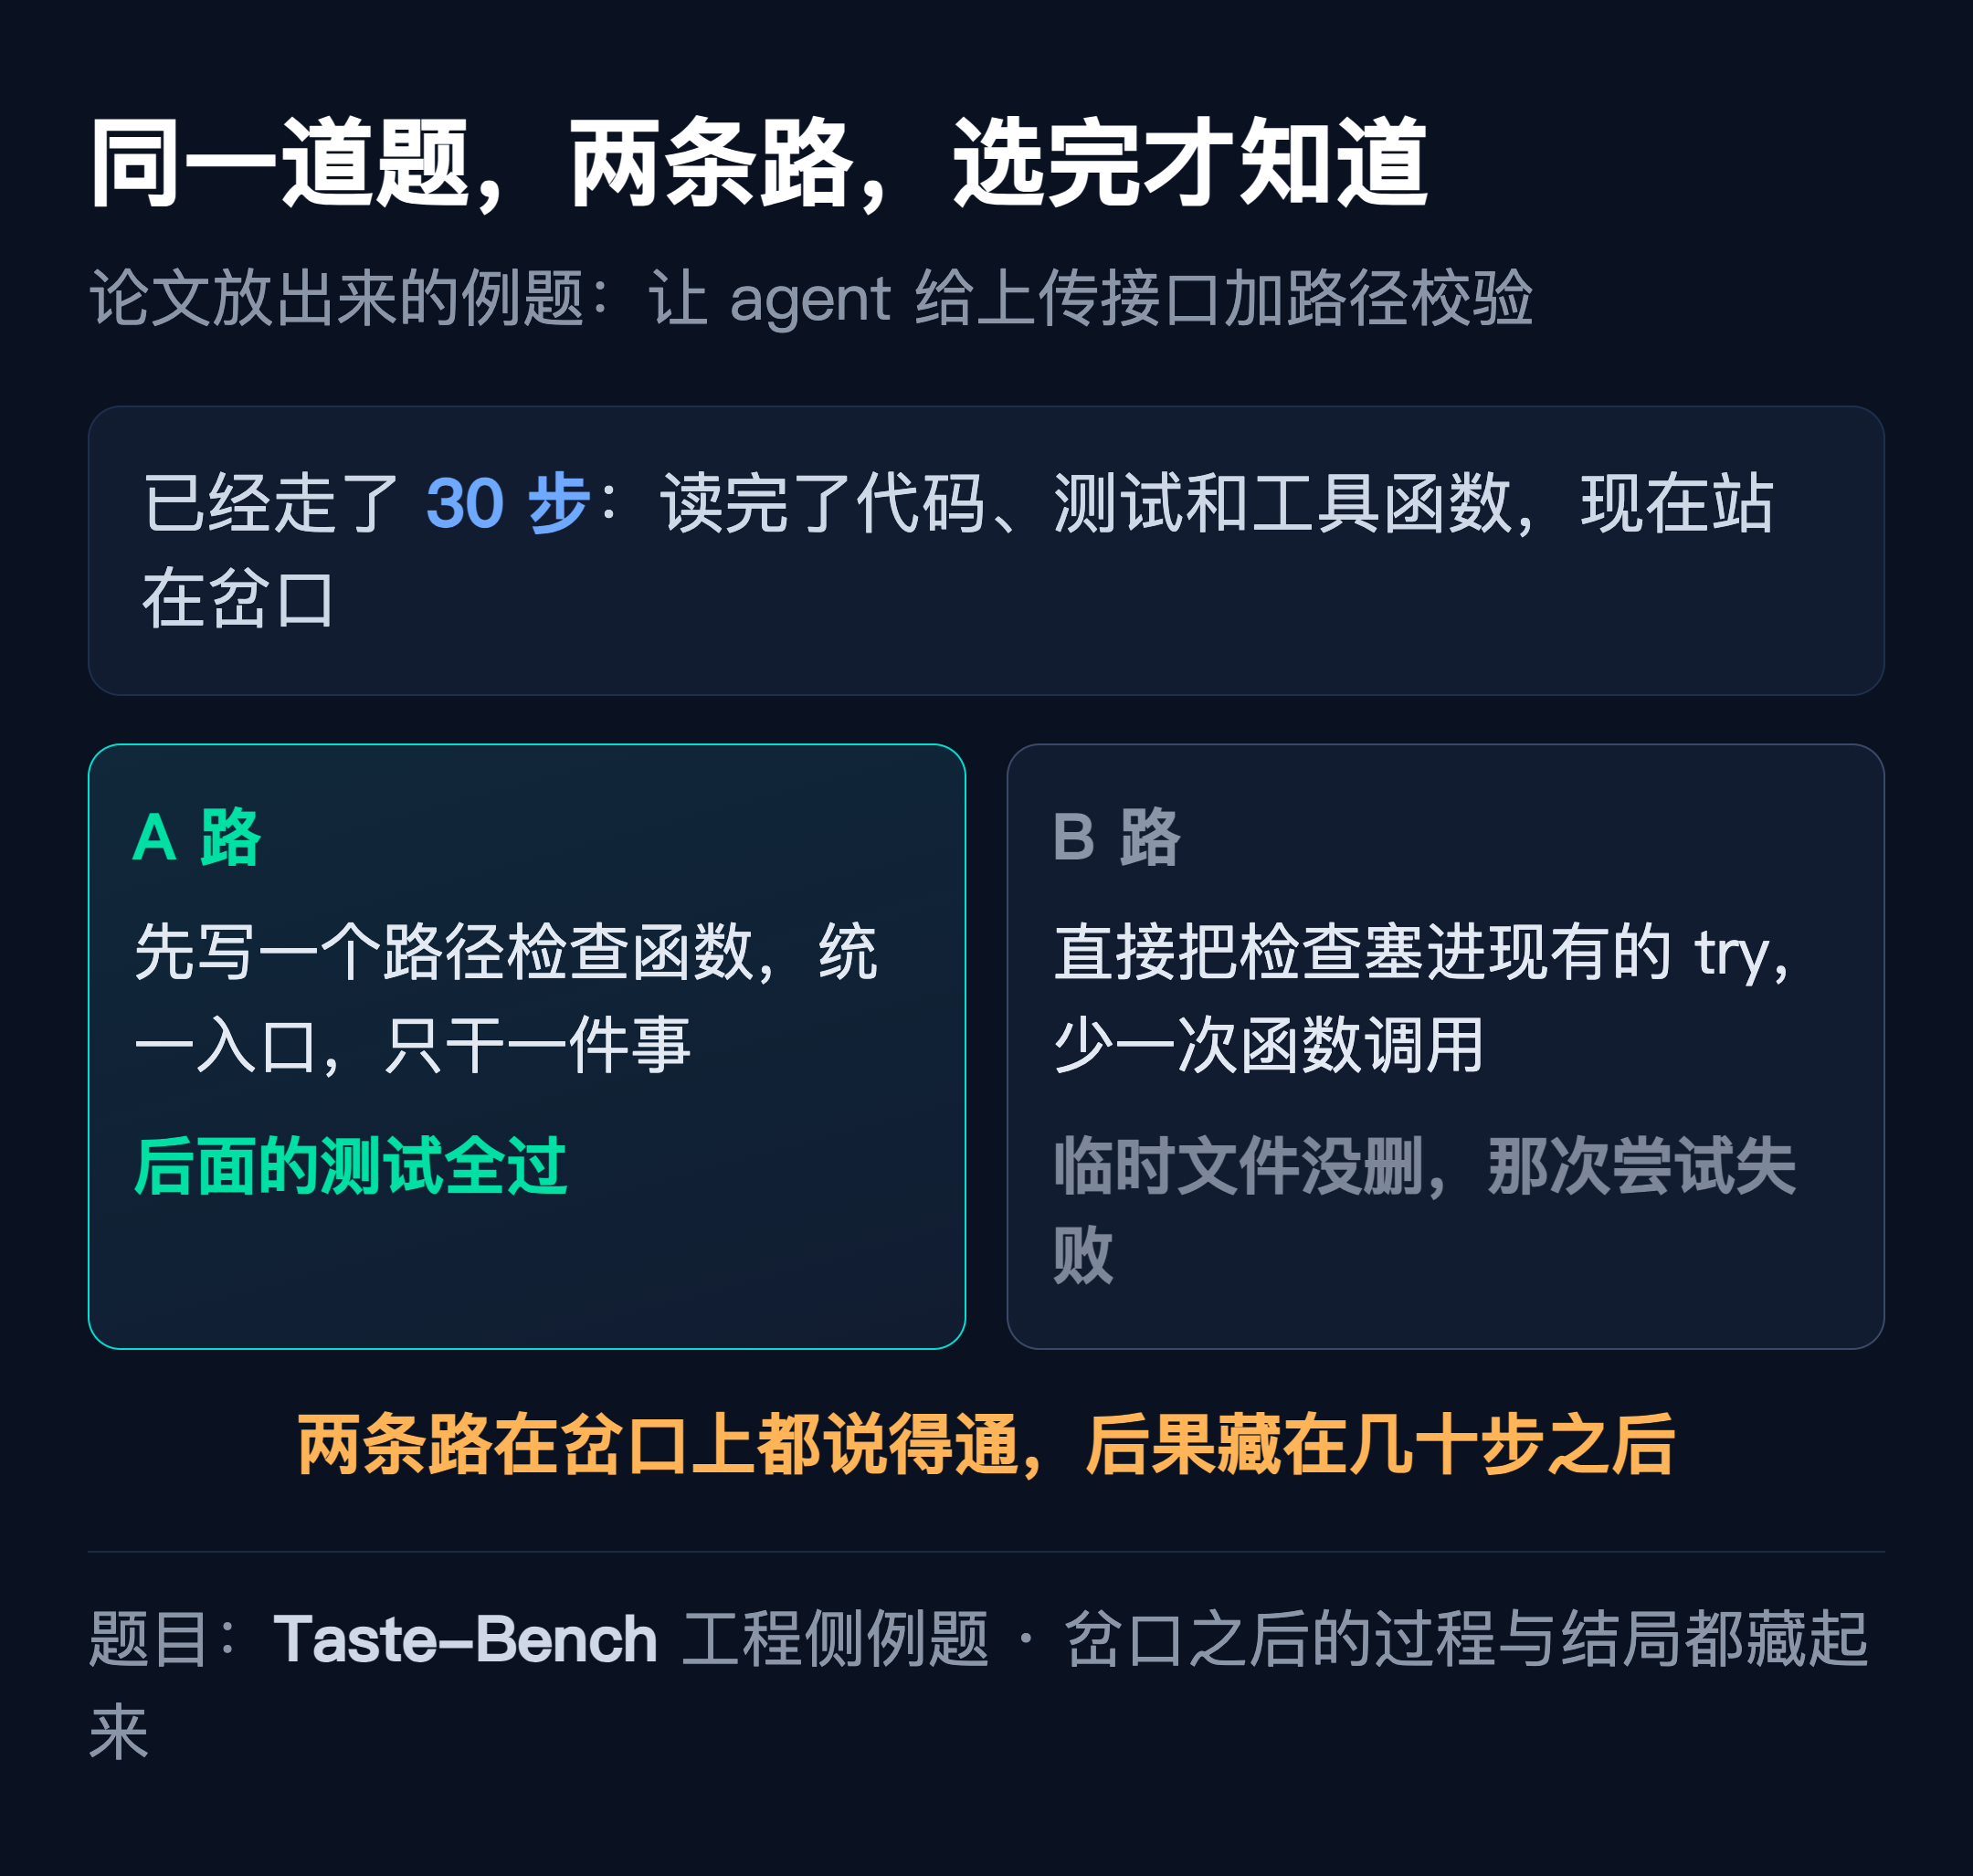
题目本身不玄乎。一个 agent 在长任务里走到岔口,两条路听上去都成立。
一条通向几十步之后能过测试,另一条通向返工。
作者把这种判断力叫 taste,直译是品味。翻成大白话,就是走到岔口时,能不能看出哪条是死路。
二选一,最高 59.7%
榜首是 GPT-5.6 Sol,59.7%,GPT-5.5 咬着 59.5%。
第三名 Claude Opus 5 掉到 55.5%。这一档往下是一串 54 到 51 的:Grok 4.5、GLM-5.2、Sonnet 5。
我们常打交道的几档落在中段:MiniMax M3 45.3,DeepSeek V4 Flash 43.3,GPT-5.4 Mini 40.1。
榜尾的 Grok 4.20 Reasoning 只有 15.7。这个数不能全算理解力。
它有 459 次作答没按格式吐出来,解析失败直接判错。
59.7 也谈不上体面。前排模型只比瞎猜的底分高出三十几个点。
真正的窟窿在掉头这一格。
题库按两种方式造。一种是平行分岔:同一个任务跑两遍,半路分道扬镳。
谁最后过了测试,那条路就是对的。另一种是绕路:agent 在一个回合里走错了,自己发现,再绕回来。
两张卷子分开算,绕路明显更难。最好的一档在绕路题上是 48.1%。
同一批模型的平行工程题,是 75.8%。Claude Opus 5 在绕路题上只有 35.3,Sonnet 5 是 36.1。
换成熟悉的场景:它已经照某个方案改了十几个文件,测试还没跑。
这时候让它判断“是不是该推翻重来”,水准接近抛硬币。
而这类翻车最贵:一条错路能把整段预算都押进去,代价要到几十步之后才结算。
时间线更扎心。论文给每个岔口标了要看多远才见分晓。
线索藏在已经走过的步骤里,14 个模型平均 62.3%;要再往后走很远才浮现,平均值掉到 21.0%。
21.0 比瞎猜的 25 还低。

加思考预算救不回来。作者挑了两个模型,把推理档位从最低开到最高,每一档的准确率几乎没动。
而在最难的那一档,模型花掉的推理 token 最多,错得也最多。
它知道这里难,就是看不出难在哪。

这本事能单独练,练完就见效
先看题怎么来的。作者没雇人出题,做法是从 agent 自己跑过的轨迹里挖。
4,657 个候选岔口过几道筛子,剩下 502 个,通过率 10.8%。工程侧 390 题,研究侧 112 题。
全部公开:代码走 MIT 协议,数据集挂在 Hugging Face,申请一下就能下。
标签也不是拍的。抽 100 题给两位评审,只给结局、不给模型选了什么。
172 个明确的 A/B 判断里,170 个和机器标的一致。两人彼此的一致率 98.6%,kappa 0.973。
这套题量出来的东西,跟考试分数不是一回事。
作者拿它跟 SWE-bench Verified 对了一遍:11 个模型,两份成绩的相关系数只有 0.63。
只看工程侧那 390 题,掉到 0.37。
还有一组更直白的数。SWE-bench Verified 前四名的成绩挤在 4.0 分之内。
同样这四个模型,在这份卷子上差了 10.7 分。光看一个跑分挑 agent,等于闭着眼买。

后半篇是这篇论文最有用的地方:品味能蒸馏。
老师模型看过结局,学生模型只看题目。
学生拿 Qwen3.6-27B 做基座,在没见过的任务上从 30.0% 提到 47.9%。
再把学生当裁判用。41 个没见过的 SWE-bench Pro 任务,解题 agent 每走到岔口,就往上下文里塞一句学生的判断。
成功率从 14.6% 抬到 33.7%。每一步都判断正确的天花板是 39.0%,学生拿走了其中大半收益。

这一招对写 agent 的人最直接。别急着换更贵的模型,也别指望让现有的多想一会儿。
在岔口插一个专门判路的角色,代价是另一个模型的一次调用。
天天用 agent 的人也有能马上改的地方。
长任务别一口气跑到黑,隔一段停下来问一句,这条路还成立吗。
判断尽量交给另一个模型。同一份上下文里,它很难否掉自己。
思考预算省下来,那部分钱和时间不会变成判断力。
边界同样清楚。蒸馏只在 Qwen3.6-27B 上做过,换基座、换任务域都没有数。
41 个任务是小样本,成功率上下浮动不小。论文还是预印本,没有第三方拿数据集跑一遍。
更麻烦的是前提。蒸馏要有看过结局的轨迹,没有几千条跑完的 agent 记录,学生模型根本训不出来。
小团队连这一层都绕不开。
这份卷子量的是看不清后果时敢不敢回头。最高分停在 59.7,说明 agent 最缺的那块,眼下不在写代码,在挑路。
评论区