

llmspeed 是个网页。挑一套硬件、挑一个模型,页面就照着那套配置的速度,把回答一个字一个字打出来。
昨天上了 Hacker News 首页,到现在 254 分,77 条评论。作者是斯德哥尔摩的 Albin Östman,正职做网页和 iOS 自动化,业余给 Appium 提交代码。

仓库 MIT 协议,80 颗星,8 月底建起来,一直在提交。
页面里塞了 30 种硬件,从 RTX 3060 到 H200,从 Mac mini 到 9950X 纯 CPU。模型 15 个,从 8B 的 Llama 到 750B 的 GLM-5.3。
排列组起来 2079 个组合。页面自己标的来源里,真跑过的只有 81 个。
32GB 的 5090,装不下 321B
GLM-5.3 Flash 有 321B 参数。在 llmspeed 的 5090 页面上,给出的最低量化是 UD-IQ1_S,结果一栏写着:装不下。
MacBook M4 Pro 24GB 也是同一行,装不下。
换成 Mac Studio M5 Ultra 256GB,装得下,Q4_K,63 tok/s。512GB 那台能上到 UD-Q4_K_XL,52 tok/s。
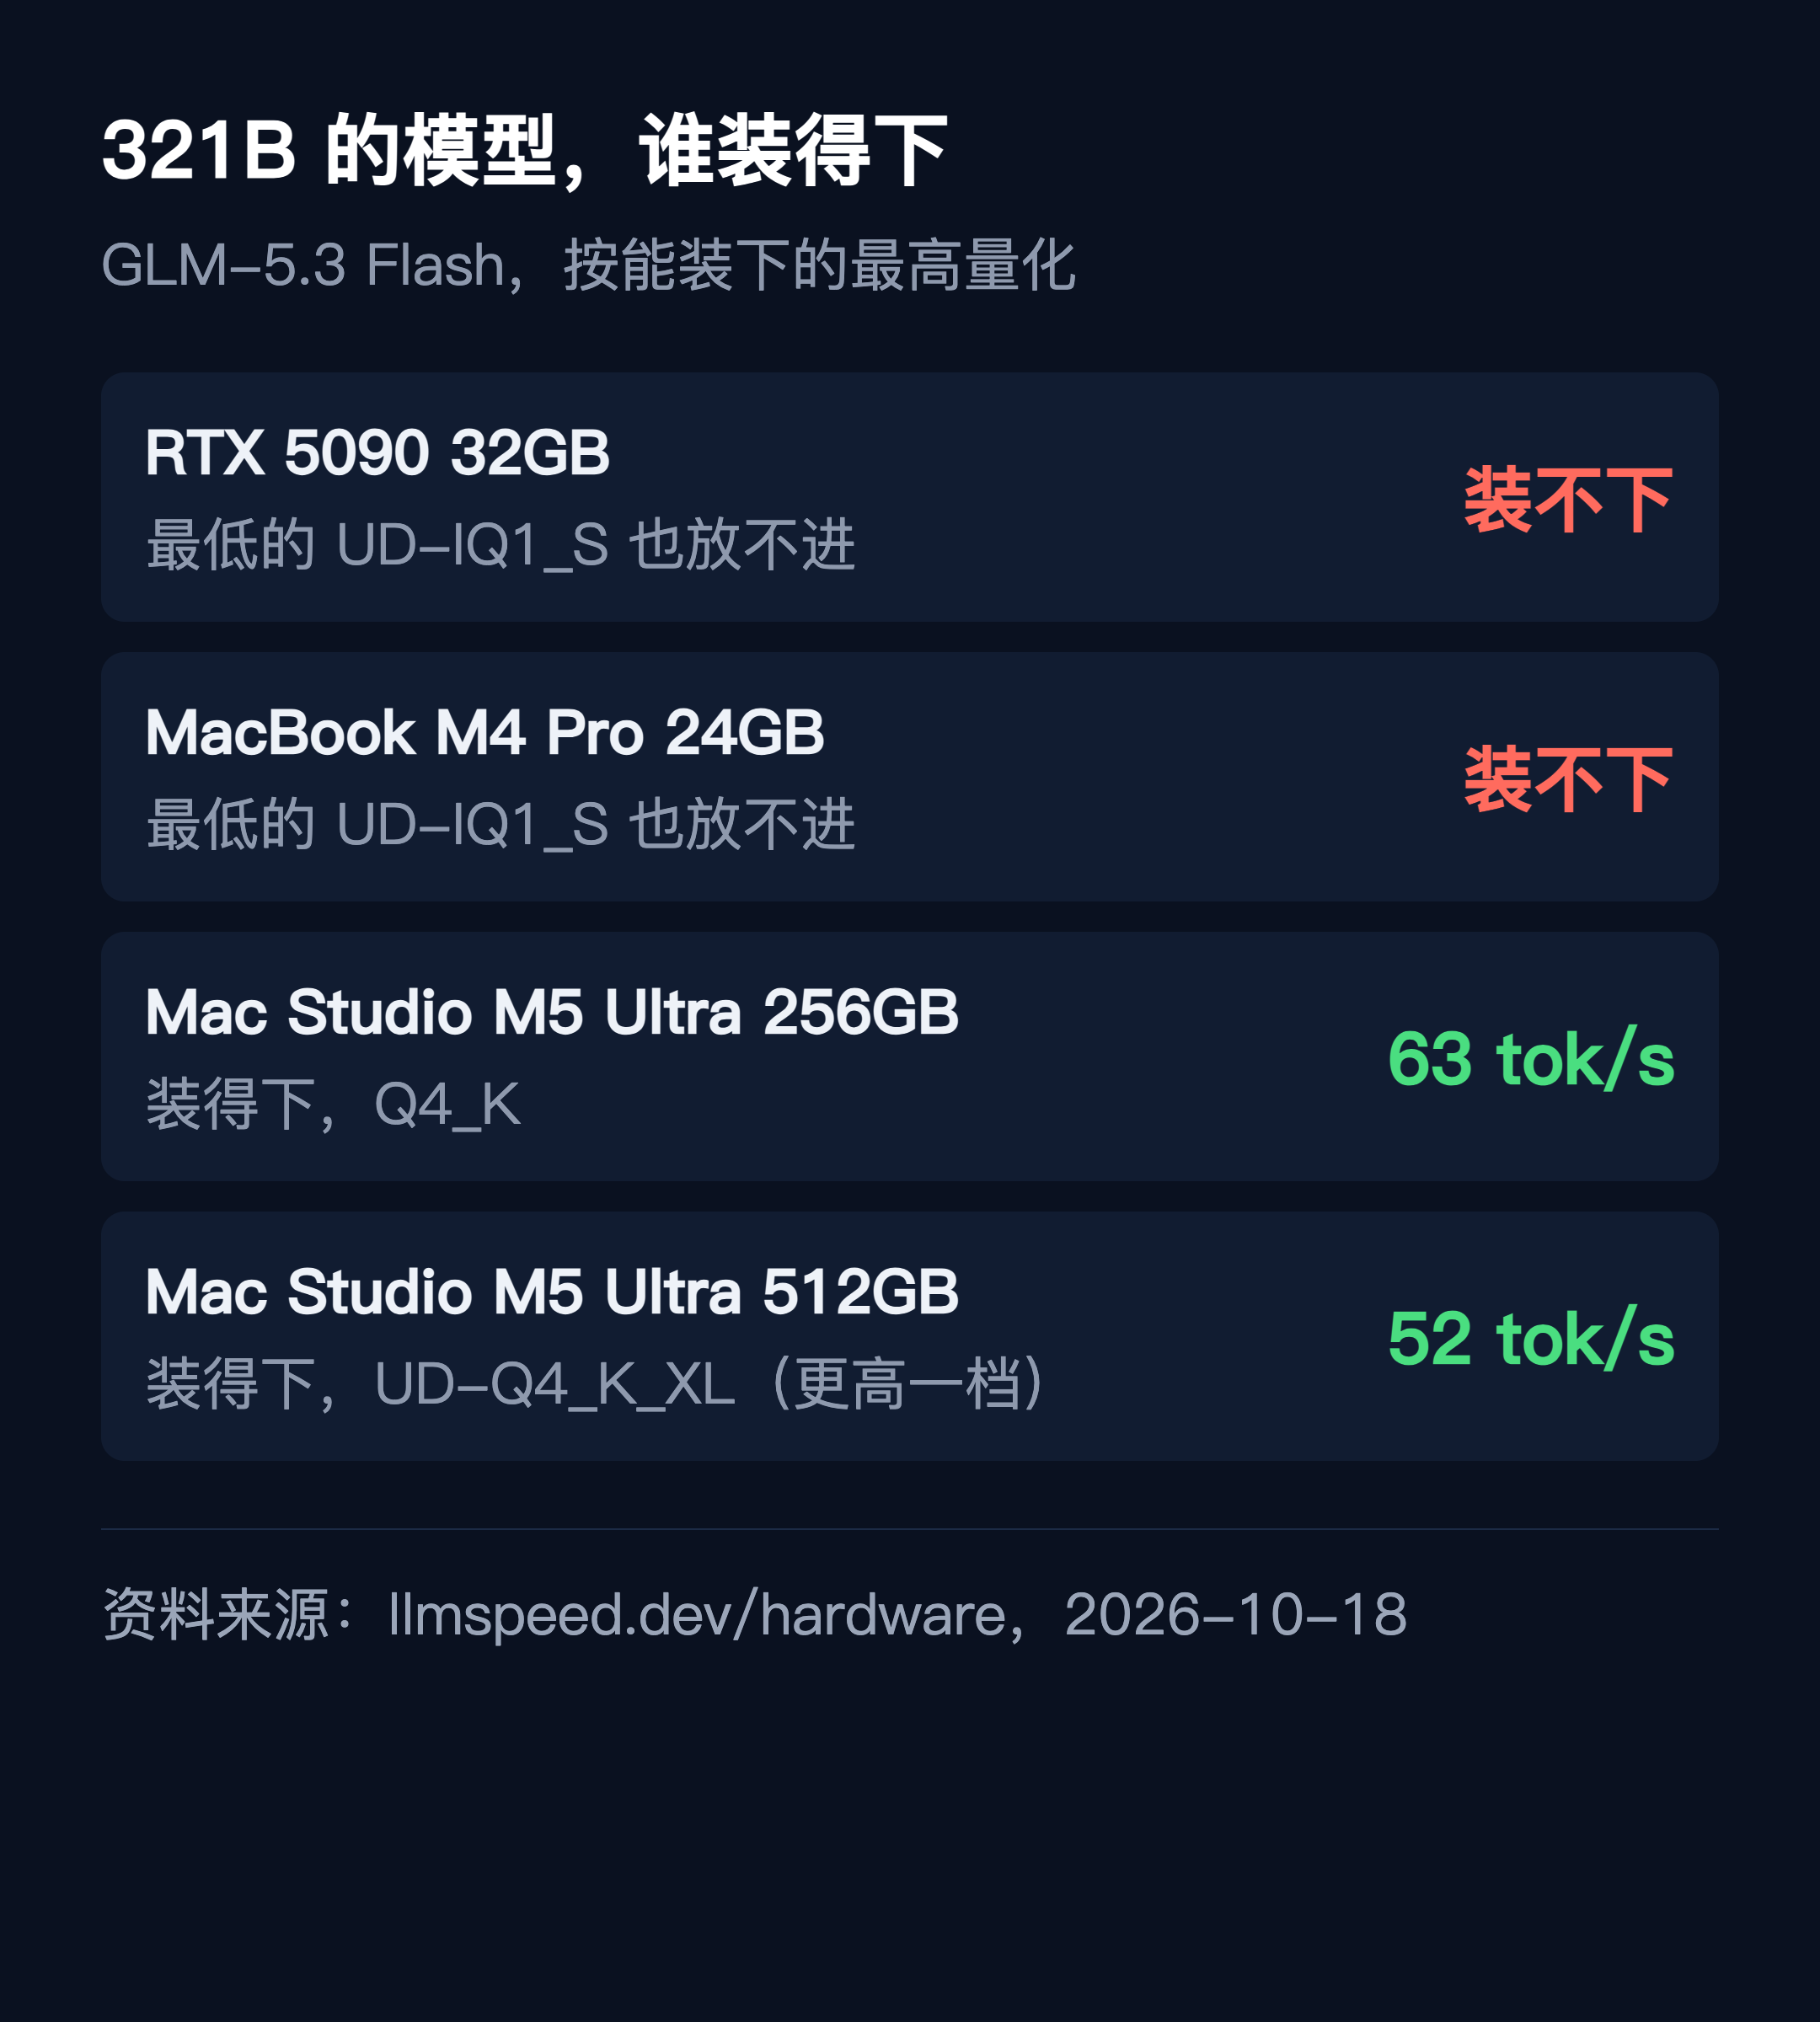
这一点比跑分表实用。跑分回答多快,这里先回答跑不跑得动。
再往下一档看,16GB 的 RTX 5070 Ti、5080、RX 9070 XT,连 Qwen 27B 的 Q4_K_M(16.82GB)都塞不进去。
买卡的人在意的从来不是峰值算力,是这张卡能不能把想跑的那个模型装进去。
要知道,装得下是下限,跑得快是上限,两码事。
同一个 27B 模型,三台机器差五倍
第二块拼图是速度。
Qwen 3.6/3.8 27B 配 Q4_K_M,是家用硬件最常见的一档组合。
RTX 5090 32GB:46 tok/s,首字 0.3 秒,标的是推算。
Mac Studio M5 Ultra 256GB:47 tok/s,首字 0.4 秒,标的是实测。
MacBook M4 Pro 24GB:8.7 tok/s,首字 0.8 秒,标的是推算。

5090 和 256GB 的 Mac Studio 打平。带宽一个是 1792 GB/s,一个是 1200 GB/s,高出五成,速度只差一个 token。
为什么速度长得像带宽,而不是算力?生成每一个 token,都要把活跃的那部分权重从内存里读一遍。MoE 只读激活参数,所以 35B A3B 这种模型在 5090 上能跑到 423 tok/s,比同卡上 27B 稠密模型的 46 快出一个量级。
首字那一段看的是算力。prefill 要把整段提示一口气算完,FP16 的算力决定这段等多久。
说到底,解码这活儿是搬数据,不是算命。
llmspeed 把这两件事拆成两个数:tok/s 和首字延迟,各自带一个问号按钮,点开是这套算法。
每个数字后面,写着一行小字
最不像广告的地方,在这里:不假装自己全知道。
每个结果旁边挂着一个小标签。Measured 是这套硬件、这个模型、这档量化上真跑过;Derived 是从相近配置插值出来;Projected 是按硬件规格算的,多用于还没上市的卡。

2079 个组合,标 Measured 的 81 个,占 3.9%。Derived 675 个,装不下 1323 个。
说白了,这张表最值钱的不是数字,是数字后面这行小字。我们平时刷到的「某某卡跑某某模型多少 token」,十篇里有九篇没交代这句。
数据来源写在 README 里:r/LocalLLaMA 的帖子、localscore.ai、llama.cpp 的讨论,一条条收。作者也接受外部提交,用 llama-bench 跑一组贴进去就行。
内存的算法也交代了:Mac 按统一内存的 75% 算,独显按显存的 93% 算,剩下的留给系统和 KV cache。
第一波质疑,全冲数字来
Hacker News 上 77 条评论,基本分成两拨。
一拨盯精度。有位用户的 M2 Ultra 128GB,跑出来比页面上 M3 Ultra 512GB 还快一倍,他留了一句:希望估算靠谱一点。作者在下面回问,你用的是哪个模型、哪档量化。
另一拨盯配置。多卡、异构(5070 加 5080 这种)、PCIe 版本、有没有 NVLink,全被点名。有人问自家那块 RX580 能不能进表。
还有一条戳得更深:做 agent 写代码的人,在意的是 prefill 能并行多少路,不是输出多少 token。这个站目前只答了后者。
也有不客气的:租一台云上的机器跑几分钟就试完了,花不到 0.5 美元。这话不算错,只是租来的机器替我们决定不了买哪张卡。
已知的短板,作者自己写在 README:只算单卡单机,上下文变长有折扣系数,但没有并行请求那一层。
问题是,多卡这条线压根没做。

所以适合两种人:准备买第一张卡、想知道 27B 能不能装进 24GB 的;手上已经有机器、想知道换一个大模型要不要换卡的。
不适合拿来当采购依据。要跑多机多卡、或者按并发吞吐算成本的,这张表答不了。
怎么用上
在线最省事,打开 llmspeed.dev,四个下拉框选完点 Run,文字就按那个速度往外走。想看两台并排,点 Race a config。
站里每个硬件有单独的页,比如 llmspeed.dev/hardware/rtx-5090/,一页把 15 个模型在这张卡上的结果全列出来,给的是装得下的最高量化,比自己一个个试快。
想自己搭一份:
git clone https://github.com/nicorobinreal/llmspeed
cd llmspeed
npm install
npm run dev
生产构建用 npm run build,整站是静态的,放 GitHub Pages 就能跑。所有预测值在 data/app-data.json,一天生成一版。
手上正好有机器的话,跑一组实测比看表管用:
llama-bench -m 你的模型.gguf -p 512 -n 128
把 tg128 和 pp512 两个数填进 benchmarks/submissions.csv,PR 里贴上完整输出,就是一组新的 Measured。
自己那台机器的数字,跑一次胜过看十张表。
体验地址:https://llmspeed.dev/
项目地址:https://github.com/nicorobinreal/llmspeed
数据:https://github.com/nicorobinreal/llmspeed/blob/main/data/app-data.json
评论区